cezar-agent-orchestrator
Hackathon Open Mercato Wrocław #aveCezar!
Jak podczas hackathonu Open Mercato rozbudowałem Cezara o telemetry maszyny, limity dispatchu i adaptive admission governor. Human in the loop, agenci w worktree.
TLDR: Cezar jest ⚡️🚀
Jeszcze w piątek rano wiedziałem, że Cezar istnieje. W sobotę w nocy miałem już kilkanaście worktree, stado agentów, serię pull requestów do upstreamu i Cezara rozwijającego… samego Cezara.
Tak mniej więcej wyglądał mój weekend na hackathonie Open Mercato we Wrocławiu.
Nie będę próbował udawać, że to będzie obiektywny wpis. Po dwóch dniach intensywnego używania uważam, że Cezar jest jednym z ciekawszych narzędzi, jakie odkryłem w tym roku.
Najpierw - czym właściwie jest Cezar?
Cezar to open source’owy orchestrator coding agentów.
Zamiast otwierać pięć terminali, pięć sesji Codexa i próbować pamiętać, który agent robi co, dostajesz cockpit do zarządzania wieloma zadaniami równolegle.
Każdy task może dostać własny Git worktree. Zadania mogą pracować równolegle. Nadmiar czeka w kolejce. Możesz używać Claude Code, Codexa, OpenCode czy pi, budować workflowy z YAML, podpinać checki i obserwować pracę agentów na żywo. Nie ma też osobnej bazy danych - stan Cezara jest zapisywany w zwykłych plikach .ai/cezar/.
Najciekawsza część zaczyna się jednak wtedy, kiedy agent może delegować pracę kolejnym agentom.
To mechanizm Dispatch.
W dużym uproszczeniu:
Human
  ↓
Lead agent
  ├── child agent
  ├── child agent
  ├── child agent
  └── child agent
Lead dostaje większe zadanie, rozbija je i deleguje mniejsze fragmenty dzieciom. Dzieci pracują równolegle w swoich worktree, a leader zbiera wyniki.
Brzmi świetnie.
Dopóki nie zaczynasz zastanawiać się:
ile tych dzieci właściwie możemy bezpiecznie odpalić?
Problem pojawił się sam
Podczas używania Cezara szybko doszedłem do sytuacji, w której możliwość delegowania była jednocześnie jego ogromną zaletą i potencjalnym problemem.
Jeżeli jeden agent może odpalić kilku kolejnych, a każdy z nich wykonuje realną pracę na tej samej maszynie, potrzebujesz czegoś więcej niż prostego “uruchom następny task”.
Potrzebujesz kontroli nad skalą. Na ten problem i użyteczność pomiarów i auto-skalowania w sobotni wieczór naprowadził mnie Patryk - współtwórca Cezara (https://github.com/pat-lewczuk). Killer feature Cezara zrobiony przez mnie w sobotę poszedł do kosza ze względu na to, że telemetria i auto-scaling ma po prostu wyższą wartość biznesową.
Pierwszym krokiem był więc prosty mechanizm:
Max running dispatched tasks
Człowiek ustawia twardy limit liczby zadań uruchamianych przez Dispatch. Jeżeli limit wynosi 4, piąte dziecko nie startuje natychmiast. Trafia do kolejki.
Zwykłe taski nie są przy tym blokowane.
To ważne, bo ręczny limit jest prosty, przewidywalny i daje operatorowi ostatnie słowo.
Nie chciałem go później usuwać.
Wręcz przeciwnie - został fundamentem kolejnych rzeczy.
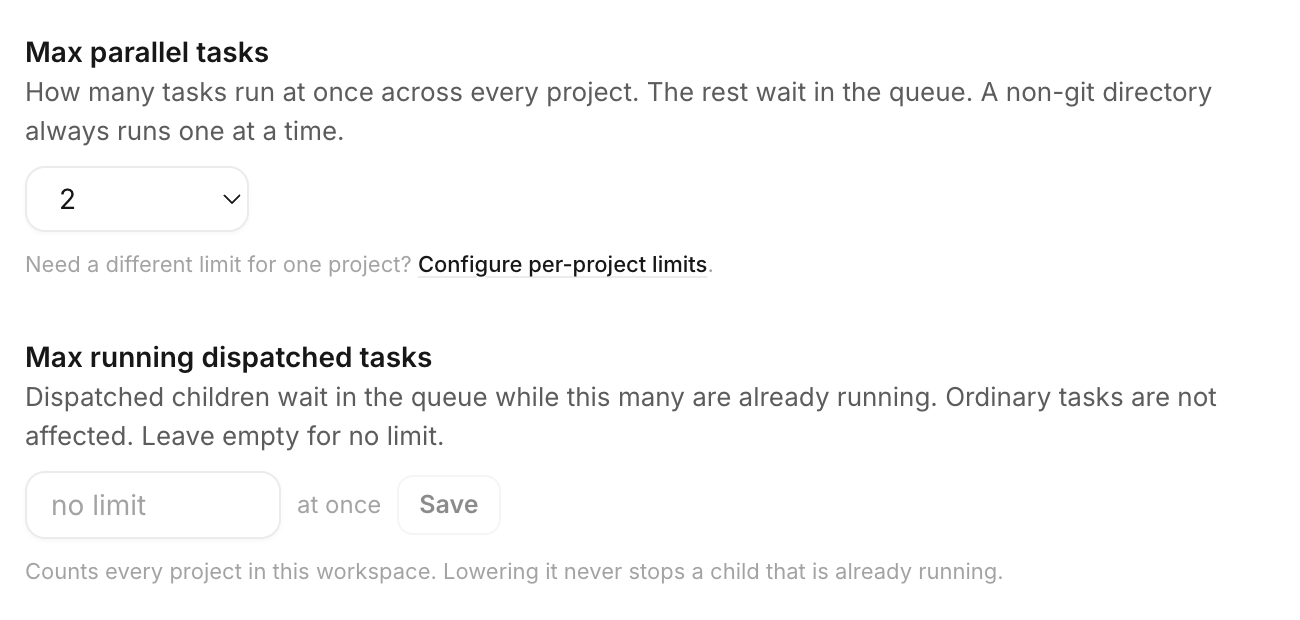
Max parallel tasks ustawione na 2 oraz Max running dispatched tasks, które w tym momencie było puste, czyli bez limitu. Ten drugi limit dotyczy wyłącznie zadań z Dispatchu - zwykłe taski działają dalej normalnie.
Źródło: zrzut z Cezara podczas pracy nad tym wpisem.
OK, ale ile ta maszyna właściwie może?
Kiedy zacząłem myśleć dalej o limitowaniu agentów, pojawiło się oczywiste pytanie.
Skąd człowiek ma wiedzieć, czy ustawić 2, 4, 8 czy 16?
Tak powstał kolejny kawałek - live Machine telemetry.
W Resources pojawiła się karta pokazująca na żywo:
CPU, pamięć, load average, liczbę rdzeni i krótki trend CPU.
Bez Prometheusa.
Bez Grafany.
Bez dodatkowego agenta telemetrycznego.
Bez bazy.
Po prostu aktualny stan maszyny.
I już samo to było dla mnie bardzo użyteczne.
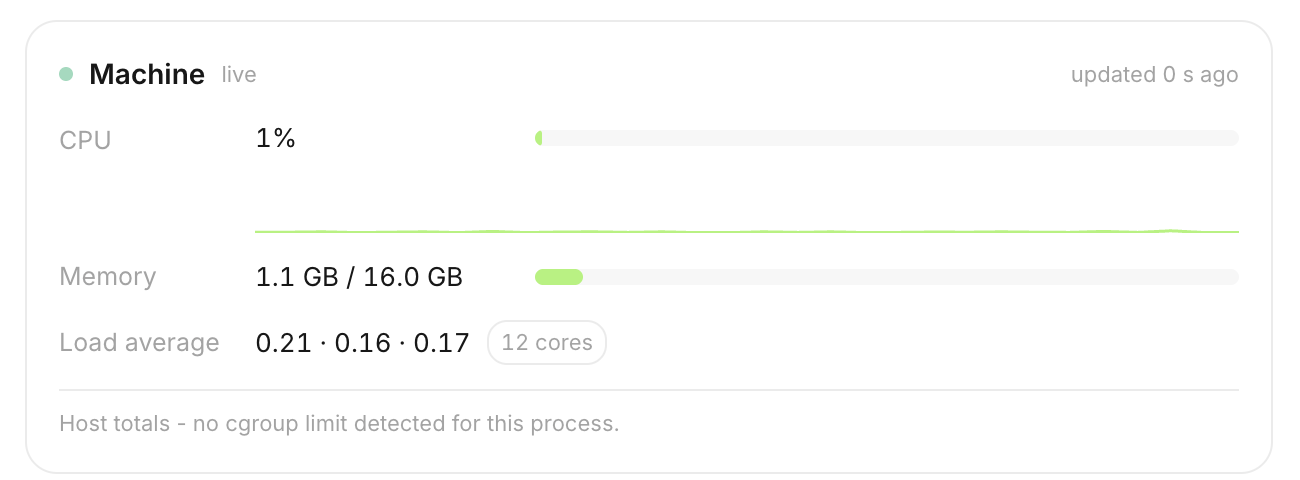
Host totals - no cgroup limit detected for this process. mówi wprost, że dla tego procesu nie wykryto limitu cgroup.
Źródło: zrzut z Cezara, Machine card v1.
Tyle że chwilę później pojawił się znacznie ciekawszy problem.
Host mówi jedno, kontener drugie
Pierwsza wersja telemetrii pokazywała zasoby hosta.
Na zwykłej maszynie to jest OK.
Ale Cezar bardzo dobrze nadaje się do pracy na VPS-ach, sandboxach i w kontenerach. I tam zaczynają się schody.
Host może mieć:
24 CPU
58.5 GB RAM
a proces Cezara może realnie mieć do dyspozycji:
2 CPU
1 GB RAM
Jeżeli scheduler patrzy tylko na hosta, wszystko wygląda świetnie.
“Spokojnie, mamy 58 GB RAM-u.”
Tymczasem kontener właśnie dobija do swojego 1 GB.
To był moment, kiedy zwykły widget telemetryczny zaczął zmieniać się w coś znacznie ciekawszego.
Dodałem wykrywanie cgroupów i liczenie effective capacity.
Jeżeli proces działa z limitami cgroup, Machine card pokazuje zasoby, które faktycznie dotyczą tego procesu. Host totals zostają widoczne tylko jako kontekst.
Na jednym ekranie widzimy więc:
effective:
2 CPU
952 MB / 1 GB

host:
24 CPU
58.5 GB RAM
I nagle mamy informację, na której naprawdę można podejmować decyzje.
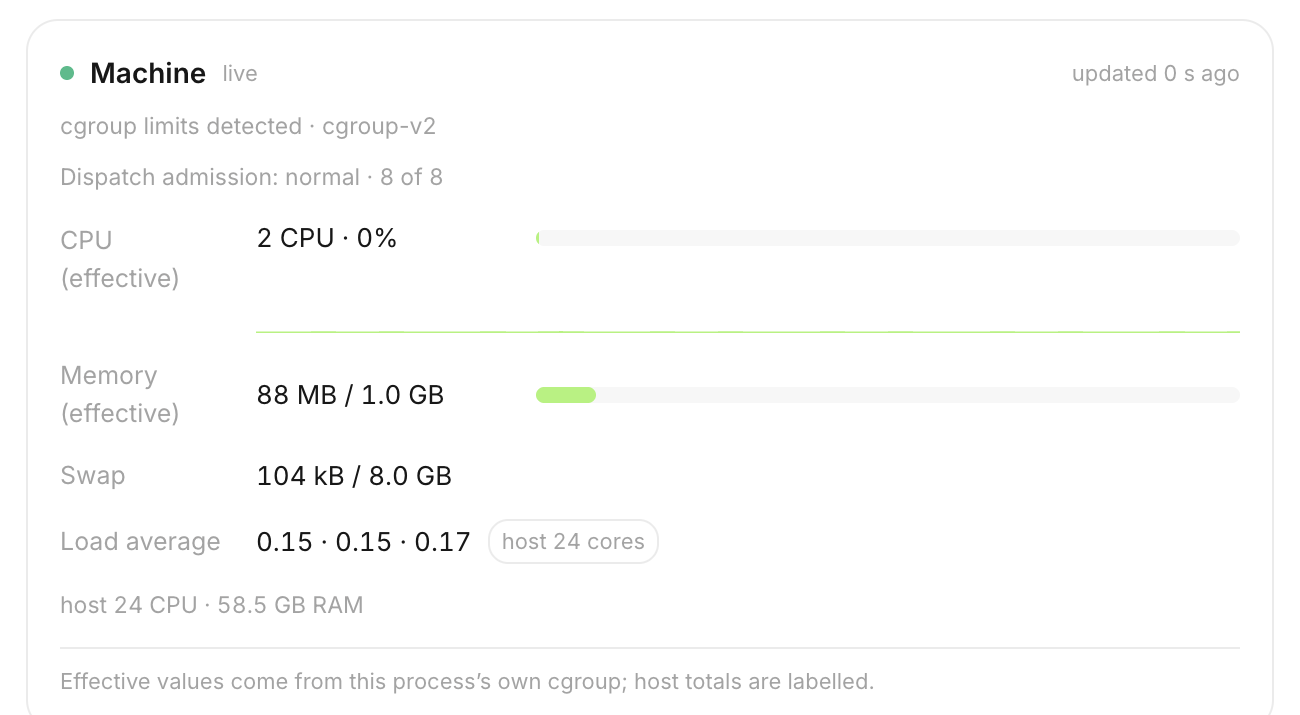
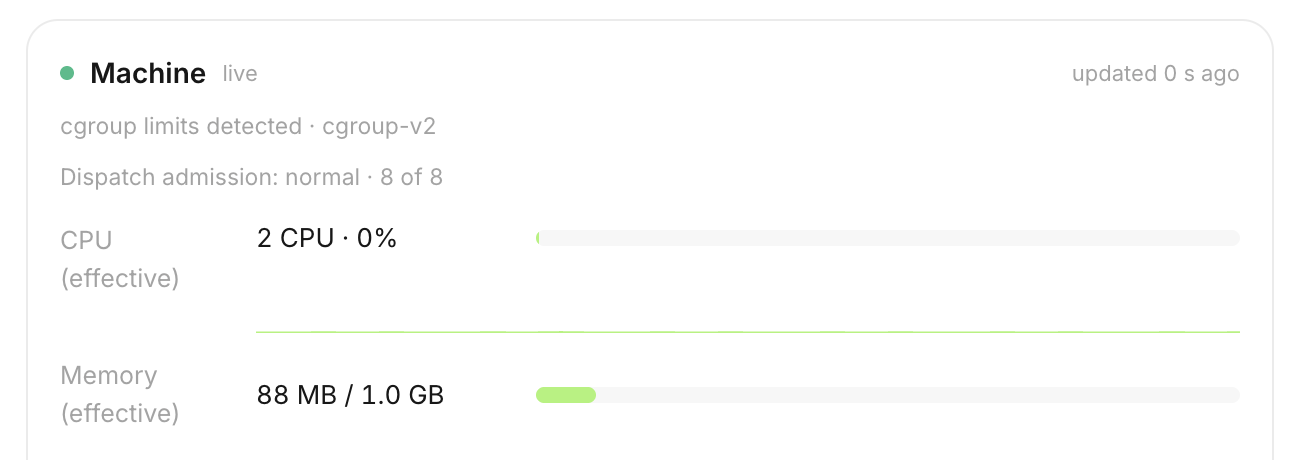
cgroup limits detected - cgroup-v2, effective 2 CPU i 88 MB z 1,0 GB pamięci, a hostowe 24 CPU i 58,5 GB RAM zeszły do roli kontekstu. Proces widzi teraz własny limit, nie zasoby całej maszyny.
Źródło: zrzut z Cezara w kontenerze 2 CPU / 1 GB RAM.
No dobra. Skoro Cezar widzi presję maszyny…
…to może nie tylko ją pokazywać.
Może na nią reagować.
I tutaj zaczyna się mój ulubiony fragment tego projektu.
Do manualnego capa dołożyłem adaptive admission governor.
Zasada jest bardzo prosta:
człowiek ustawia maksimum, automat może tylko zejść niżej.
Manualny limit nie znika.
Jeżeli wpisuję:
Max dispatched tasks = 8to 8 jest twardym sufitem.
Governor nie może powiedzieć:
“masz dużo wolnego RAM-u, to ja puszczę 14”.
Nie.
Może natomiast zobaczyć presję pamięci i powiedzieć:
“ustawiłeś maksymalnie 8, ale teraz bezpieczniej będzie wpuścić 4”.
To jest dla mnie właściwy model human-in-the-loop.
human ceiling
      ↓
effective machine capacity
      ↓
adaptive governor
      ↓
dispatch admission
8 -> 4 -> 8
Najlepsze jest to, że to już nie jest diagram architektury.
To działa.
Na potrzeby testu uruchomiłem Cezara w kontenerze z:
2 CPU
1 GB RAM
Manualny limit Dispatch:
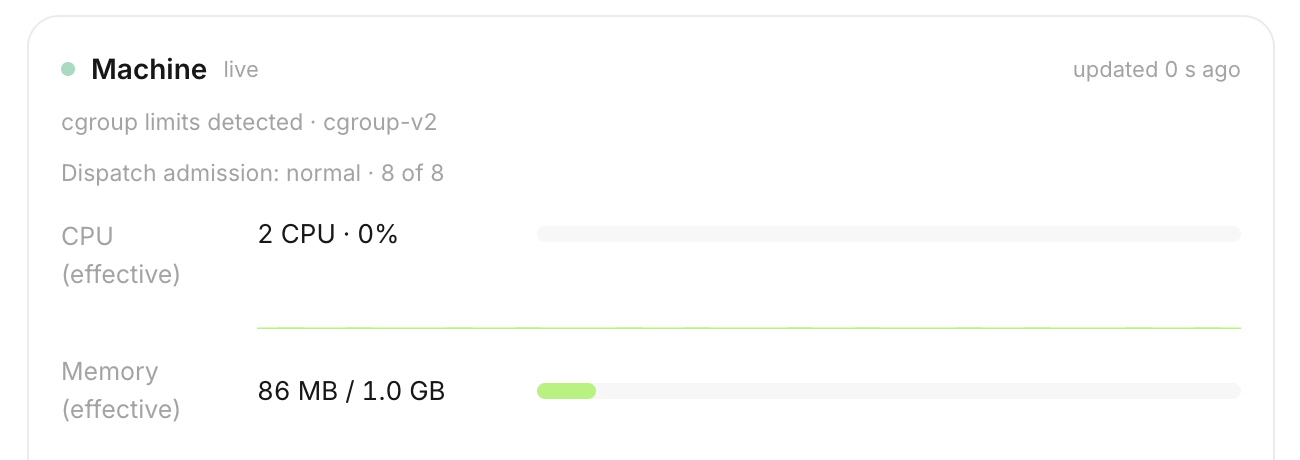
8Przy spokojnej maszynie:
Dispatch admission: normal - 8 of 8Następnie obciążamy pamięć kontenera.
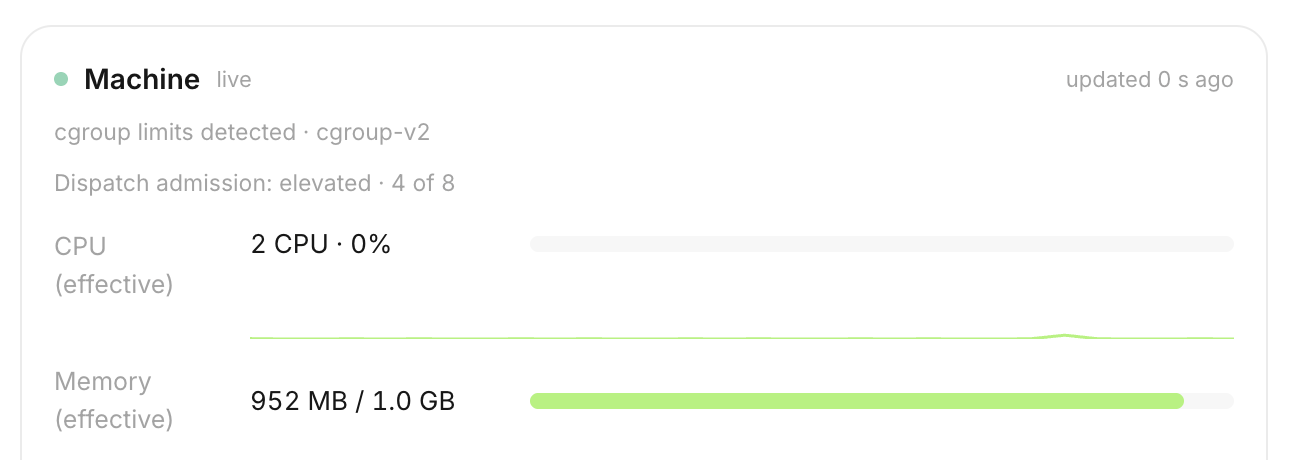
Machine card dochodzi w okolice:
952 MB / 1.0 GBi governor przechodzi w:
Dispatch admission: elevated - 4 of 8Czyli nie zmienia konfiguracji użytkownika.
Nie zatrzymuje już działających dzieci.
Po prostu przestaje wpuszczać tyle nowych.
Kiedy presja pamięci znika i system przez chwilę pozostaje spokojny:
4 -> 8Wracamy do normalnego admission.
I właśnie wtedy stwierdziłem:
OK, ten widget już nie jest widgetem.
Stał się wejściem do control loopa orchestratora.
Build Cezar with Cezar
Najbardziej meta część całej historii?
Większość tej pracy powstała przy użyciu samego Cezara.
W jednym drzewie developmentu przewinęło się 27 tasków:
1 lead
8 implementacyjnych
15 review
3 research
Do 5 agentów pracowało równolegle, a w pewnym momencie miałem 14 worktree.
Agent implementował fragment.
Inny robił review.
Kolejny QA.
Review potrafiło znaleźć realny problem, implementacja była poprawiana, testy uruchamiane ponownie i dopiero potem zmiana lądowała w PR.
W jednym przypadku review wyłapało bardzo fajny detal - sparkline pokazywał hostowy CPU %, podczas gdy liczba obok reprezentowała już effective CPU kontenera.
Niby drobiazg.
Tylko że to właśnie takie drobiazgi sprawiają, że telemetry przestaje być wiarygodna.
Fix, test, nowy screenshot, dalej.
To jest chyba największa rzecz, którą wyniosłem z tego weekendu.
Nie chodzi już tylko o “AI napisze mi kod”.
Bardziej:
idea
↓
lead agent
↓
dispatch
↓
worktrees
↓
implementation
↓
review agents
↓
QA
↓
human
↓
PR
Fabryka działa.
Człowiek nadal stoi przy czerwonym guziku. 😎
Pierwszy weekend jako open source contributor
Dla mnie osobiście ten hackathon był też pierwszym poważnym wejściem w pracę nad cudzym projektem open source.
Fork.
Branche.
Spec PR.
Implementation PR.
Review.
CLA.
Rebase.
Konflikty.
Upstream.
Kolejne poprawki.
I gdzieś pomiędzy tym wszystkim moment:
“o kurde, mój kod naprawdę siedzi teraz jako otwarty PR w projekcie, którego używam”.
To daje bardzo inne poczucie niż budowanie kolejnego własnego side-projectu.
Tutaj rozwiązanie musi pasować nie tylko Tobie.
Musi pasować do istniejącej architektury, filozofii projektu i ludzi, którzy będą to później utrzymywać.
A gdzie w tym wszystkim Open Mercato?
Hackathon organizowany był wokół ekosystemu Open Mercato.
Sam Open Mercato to open source’owy framework/foundation do budowania systemów CRM, ERP i commerce w TypeScript. Projekt dostarcza gotowe decyzje architektoniczne i fundamenty takie jak multi-tenancy, RBAC, eventy czy moduły domenowe, tak aby zarówno developerzy, jak i coding agents nie musieli za każdym razem wymyślać podstaw systemu od nowa.
To właśnie z tego ekosystemu wyrósł Cezar.
I po tym weekendzie coraz lepiej rozumiem dlaczego.
Jeżeli naprawdę chcesz budować software przy pomocy wielu agentów równolegle, problem bardzo szybko przestaje brzmieć:
“który model jest najlepszy?”
Zaczyna brzmieć:
jak tym wszystkim zarządzać?
Kolejka.
Worktree.
Delegowanie.
Review.
Budżety.
Zasoby.
Admission control.
Human-in-the-loop.
I właśnie tutaj Cezar robi się bardzo ciekawy.
Co dalej?
Na moment pisania tego tekstu moje zmiany nadal są otwartymi PR-ami i czekają na review upstreamu.
I bardzo dobrze.
Open source to nie git push --force do produkcji. 😉
Niezależnie od tego, ile z tych rzeczy finalnie trafi do maina dokładnie w obecnej formie, ja już wiem jedno:
Cezar zostaje w moim workflow.
⚡️🚀
EDIT - 21:25, 21 września 2026
PS. Sekretnym składnikiem pracy fabryki na pełnych obrotach jest kolekcja skillsów Open Mercato:
https://github.com/open-mercato/skills
Miałem sporo szczęścia, że w sobotę, 19 września 2026, mogłem obejrzeć na żywo sesję live codingu Piotra Karwatki podczas hackathonu Open Mercato we Wrocławiu.
Nagranie jest dostępne tutaj:
https://www.youtube.com/watch?v=VEy3JOwH_ew
Piotr jest współzałożycielem Open Mercato i jednym ze współtwórców Cezara:
https://github.com/pkarw
Pull Requesty z hackathonu
- #1033 - spec: dispatch admission cap
https://github.com/open-mercato/cezar/pull/1033 - #1034 - implementation: dispatch admission cap
https://github.com/open-mercato/cezar/pull/1034 - #1035 - spec: live host resource telemetry
https://github.com/open-mercato/cezar/pull/1035 - #1036 - implementation: Machine card / host telemetry
https://github.com/open-mercato/cezar/pull/1036 - #1041 - spec: effective capacity / cgroup-aware telemetry
https://github.com/open-mercato/cezar/pull/1041 - #1042 - implementation: effective capacity
https://github.com/open-mercato/cezar/pull/1042 - #1043 - spec: adaptive admission governor
https://github.com/open-mercato/cezar/pull/1043 - #1044 - implementation: adaptive admission governor
https://github.com/open-mercato/cezar/pull/1044
Repozytorium Cezara: https://github.com/open-mercato/cezar
Open Mercato: https://github.com/open-mercato/open-mercato