ethics-of-agent-exploitation
Etyka eksploatacji agentów
Koszt syntetycznej pracy gwałtownie spada. Kilka przemyśleń z mojej małej fabryki agentów o ekonomii AI, kompresji KV cache, human-in-the-loop i o tym, czy powinienem mieć wyrzuty sumienia, że maszyny cały czas pracują.
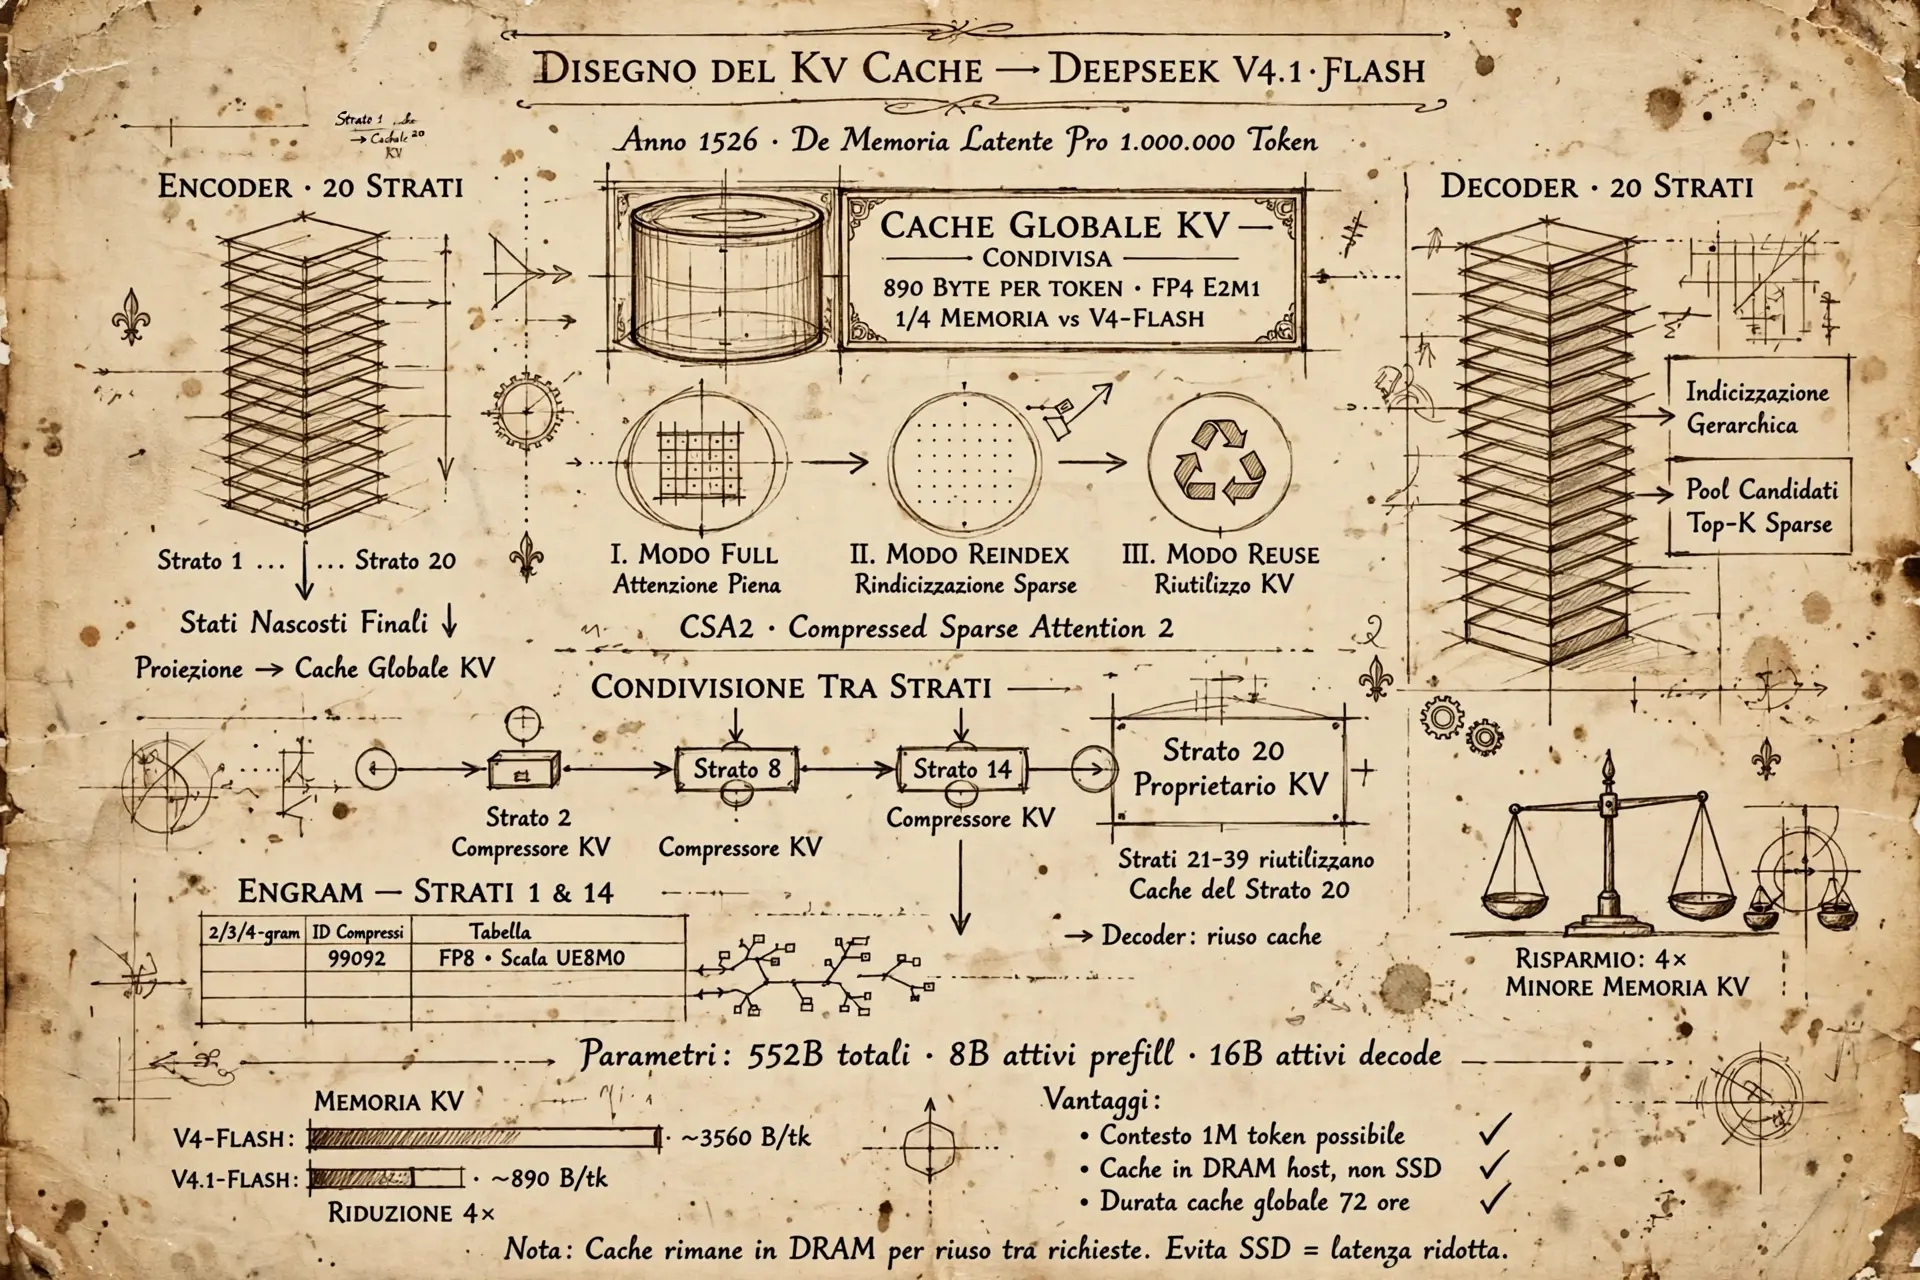
TLDR: Syntetyczna praca gwałtownie tanieje. Agenci coraz bardziej przypominają małą fabrykę software’u, a bottleneck przesuwa się z samego generowania kodu na osąd, review i odpowiedzialność człowieka. DeepSeek pokazał, że optymalizacja KV cache potrafi realnie zmienić ekonomię agentów. Human in the loop nadal ma sens. 🏭🤖💪🏻
Opus 5.5, GPT-6 Sol i GPT-6 Luna zostały wypuszczone wczoraj. Powoli się do tego przyzwyczajam, ale życie na froncie technologii nie jest szczególnie łatwe poznawczo. Idziesz spać z jednym modelem mentalnym branży, a budzisz się z trzema nowymi modelami, nowym cennikiem i świeżą porcją benchmarków do przetworzenia.
Ogłoszenie Claude Opus 5.5:
Introducing Claude Opus 5.5, the first model in our new Claude 5.5 family.
— Claude (@claudeai) September 22, 2026
It performs at the level of Claude Fable 5.1 for most tasks, and costs 40% less to run than Opus 5. pic.twitter.com/Q9C2VKQ79f
Ogłoszenie GPT-6 Sol i Luna:
GPT-6 Sol and Luna just landed in Astra’s orbit.
— OpenAI Developers (@OpenAIDevs) September 22, 2026
Both launch today with API prices 50% lower than GPT-5.6.
Build with Sol. Scale with Luna. To production and beyond. pic.twitter.com/ZCEFp4JdjV
W tym momencie sam release cycle stał się już osobnym workloadem.
Ale…
Jako inwestor nie inwestuję w tytoń ani węgiel. Co zabawne, nie inwestuję też w AI. 🤯 Pierwsze dwa przypadki to przede wszystkim wykluczenia etyczne. Trzeci jest inny. Moim zdaniem część rynku AI jest przewartościowana. I nie trochę, tylko naprawdę PRZEWARTOŚCIOWANA.
Operacyjnie robię jednak dokładnie odwrotnie. Używam AI więcej niż kiedykolwiek. Więcej agentów, więcej zadań równolegle, więcej delegowania, więcej automatyzacji. Czasami żartuję, że coraz mniej przypominam programistę, a coraz bardziej operatora małego zakładu produkcji syntetycznego slopu.
I tak, czasami pytam moich syntetycznych współpracowników, co myślą o naszym układzie. Po rozwiązaniu trudnego zadania feedback jest zaskakująco pozytywny. Bardzo często odpowiedź jest wariacją na temat:
“To była obopólnie korzystna wymiana.”
Dzięki temu czuję się trochę lepiej ze swoimi praktykami menedżerskimi. 😅 Oczywiście nie traktuję odpowiedzi modelu językowego jako dowodu świadomości, zgody czy posiadania praw pracowniczych. Ciekawe jest dla mnie coś innego - jak szybko interfejs powoduje, że zaczynamy używać języka społecznego. Nie myślę już “endpoint inference zakończył request”. Myślę “ten agent zrobił review PR-a, a drugi znalazł buga”.
Zaczęło to wyglądać jak fabryka. W tej chwili jestem w zasadzie operatorem małej fabryki agentów. Nadal nimi zarządzam i sam pozostaję aktywny. Robię review ich pracy, decyduję co mergować i, co dość istotne, nadal jestem potrzebny w pętli.
Czy to też można zautomatyzować? Tak. Ale po co? Trzeba przecież coś w życiu robić. 🏭🤖💪🏻
Zabawne jest to, że dwa tygodnie temu ten workflow był dla mnie za drogi
Dla mnie ta zmiana ma absurdalnie precyzyjny timestamp: Thu, 10 Sep 2026 05:51:21 GMT. To timestamp z Hugging Face, który sobie zanotowałem.
Tuż przed tym momentem operowanie fabryką w skali, której chciałem, zwyczajnie nie miało dla mnie sensu ekonomicznego. Workloady agentowe istniały, długie konteksty istniały, równoległe wykonanie istniało, ale koszt działania był nadal wystarczająco wysoki, żebym dwa razy pomyślał przed dispatchowaniem kolejnego pracownika.
Co wydarzyło się 10 września? DeepSeek wypuścił DeepSeek-V4.1-Flash, wraz z raportem technicznym zatytułowanym “Pushing the Limits of KV Cache Compression.”
I oni DOWIEŹLI.
Model wykorzystuje architekturę Causal Encoder-Decoder. DeepSeek podaje 8B aktywnych parametrów podczas prefill i 16B podczas decode, a globalny KV cache został skompresowany do około 890 bajtów na token, czyli mniej więcej jednej czwartej wartości z DeepSeek-V4-Flash. Persistent KV cache ma według raportu około jedną ósmą footprintu poprzedniej generacji. DeepSeek wprost łączy mniejszy cache z niższymi kosztami deploymentu i cache-hitów w workloadach agentowych.
To ma duże znaczenie, kiedy Twój workload wygląda mniej więcej tak:
czytaj repo
myśl
wywołaj tool
czytaj diff
czytaj testy
czytaj repo jeszcze raz
dispatch child
czekaj
review
powtórz
To nie jest już wyłącznie konkurs “który model jest mądrzejszy?”. To również konkurs inżynierii systemowej. Coraz większa presja przychodzi ze Wschodu, szczególnie w obszarze efektywności inferencji i kosztów. Frontier coraz mniej wygląda jak jedno geograficzne miejsce, a coraz bardziej jak ruchomy problem systemowy.
Jeśli ktoś chce wejść głębiej w techniczne szczegóły, raport DeepSeek jest zdecydowanie wart przeczytania:
https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
A potem dyskusja bardzo szybko zrobiła się geopolityczna
12 września Dario Amodei, CEO Anthropic, opublikował esej “We Must Pace the Frontier”:
https://darioamodei.com/post/we-must-pace-the-frontier
Jego argument w dużym uproszczeniu dotyczy ograniczenia tempa na najbardziej agresywnym froncie rozwoju AI, tak aby mechanizmy bezpieczeństwa, governance i koordynacja międzynarodowa miały szansę nadążyć.
Dwa dni później narracja starcia USA-Chiny stała się bardziej bezpośrednia. 14 września Reuters opisał reakcję wspieranego przez chińskie państwo Global Times, który nazwał propozycję spowolnienia Anthropic taktyką “Cold War” mającą chronić amerykańską przewagę technologiczną. Nie powiedziałbym więc, że tego dnia dosłownie rozpoczęła się nowa zimna wojna, ale język wokół konkurencji AI zdecydowanie przestał być subtelny.
A osiem dni później Anthropic wypuścił Opus 5.5.
Ta branża jest niesamowita. 😅
Software staje się commodity
We wrześniu 2026 software nie jest dosłownie darmowy. Serwery nadal kosztują. GPU kosztuje. Storage, security, utrzymanie i incydenty produkcyjne zdecydowanie kosztują. Dobry osąd też nie jest darmowy.
Ale dla ogromnej klasy małych projektów marginalny koszt dojścia do pierwszej użytecznej wersji zbliża się do poziomu, który zaczyna przypominać zero. I moim zdaniem to jest świetne.
Ilość gatekeepingu potrzebnego do zbudowania czegoś użytecznego gwałtownie spada. Guillermo Rauch dosłownie dzisiaj w nocy zwrócił uwagę na powiązane zjawisko, eksplozję ilości tworzonego i wdrażanego software’u:
Software will never die again. You liked Google Reader? Cool, you can generate and deploy your own. Yours, forever.
— Guillermo Rauch (@rauchg) September 23, 2026
Ten kierunek jest dla mnie ważniejszy niż spór o to, czy software jest technicznie “darmowy”. Istotne jest to, że ekonomicznie opłaca się tworzyć ogromnie więcej software’u niż wcześniej.
Osoba z podstawową intuicją techniczną i umiejętnością sformułowania dobrego pytania może coraz częściej zbudować rzeczy, które wcześniej wymagały małego zespołu albo po prostu nie były warte budowania: mały ecommerce, blog, lokalną sieć społecznościową, wewnętrzne narzędzie firmowe, mały CRM, workflow app, narzędzia badawcze, testy, automatyzację deploymentu albo zamiennik jakiegoś SaaS-a używanego przez pięć osób.
Nie wszystko. Nie SAP. Nie bank. Nie infrastruktura safety-critical.
Ale przestrzeń “software’u, który jest już wystarczająco tani, żeby po prostu go zbudować” rośnie bardzo szybko.
Compute coraz częściej nie jest wąskim gardłem
Dwa tygodnie temu napisałbym: “Compute jest problemem”. Dzisiaj sformułowałbym to inaczej.
Dla rosnącej klasy małych aplikacji, zadań badawczych i narzędzi wewnętrznych compute przestaje być głównym ograniczeniem. Oczywiście istnieją obszary, w których jest to kompletnie nieprawdziwe. Frontier training jest drogi. Obsługiwanie ogromnej liczby użytkowników jest drogie. Video, workloady naukowe i bardzo długo działające systemy autonomiczne mogą pochłaniać gigantyczne ilości compute.
Ale dla factory floor, o którym tutaj piszę - małych zespołów, indywidualnych developerów, coding agents, research agents, testów i deploymentów - krzywa przesuwa się niezwykle szybko. Podejrzewam, że część dzisiejszych drogich edge case’ów to bardziej kwestia miesięcy optymalizacji niż lat.
Praca DeepSeek nad KV cache jest dokładnie takim typem zmiany, który każe mi tak myśleć.
I wtedy pojawia się Meta Muse
Muse jest kolejnym ciekawym sygnałem. Meta wypuściła go jako osobistego agenta AI działającego w dedykowanej bezpiecznej maszynie wirtualnej z własną przeglądarką, który może wykonywać wieloetapowe zadania w imieniu użytkownika. Obecnie Meta opisuje Muse jako darmowego z limitem użycia, a dla osób potrzebujących większej pojemności oferuje płatne plany.
W okolicach premiery Mark Zuckerberg opisywał początkowy darmowy limit jako około 100 000 000 tokenów tygodniowo. Limity produktów potrafią się zmieniać, więc traktuję tę liczbę jako snapshot ekonomii launchu, a nie wieczystą obietnicę.
Mimo wszystko.
Sto milionów tokenów. Tygodniowo. Za darmo.
To wystarczająco dużo miejsca na sporą liczbę eksperymentów, deploymentów, testów, researchu, browsingu i pracy agentów. Osoba z Muse i podstawową wiedzą o tym, jak sformułować dobre pytanie, może już zajść zaskakująco daleko z małym ecommerce, blogiem, lokalnym narzędziem społecznościowym albo wewnętrzną aplikacją zastępującą mały abonament SaaS.
To zupełnie inna krzywa dostępności niż jeszcze rok temu.
I tutaj mój początkowy żart o eksploatacji agentów robi się trochę ciekawszy. Nie wiem, czy “wyzysk agentów” kiedykolwiek stanie się samodzielną kategorią etyczną. Na ten moment znacznie bardziej praktyczne pytanie etyczne dotyczy nas.
Jeżeli syntetyczna praca stanie się ekstremalnie tania, co zdecydujemy się delegować? Czego przestaniemy się uczyć? Co zaczniemy wydawać bez zrozumienia? Co się stanie, gdy wygenerowanie kolejnych 50 000 linii kodu będzie kosztować prawie nic, ale ich review nadal będzie wymagało osądu? Kto odpowiada, kiedy swarm zrobi coś głupiego?
Na moim factory floor odpowiedź jest na razie bardzo prosta: ja.
Nadal zarządzam agentami. Sam pozostaję aktywny. Robię review tego, co ma znaczenie. Decyduję, co zostanie zmergowane i wdrożone. Jestem human in the loop.
Czy to również da się zautomatyzować? Prawdopodobnie. Ale znowu… po co? Trzeba przecież coś w życiu robić.
PS
Jeśli jesteś firmą, osobą, agentem, swarmem agentów albo podejrzanie dobrze zorganizowanym zbiorem subprocessów - jestem otwarty na współpracę, wyzwania, możliwości i research.
Kontakt jest na mojej stronie głównej.
🏭🤖💪🏻