cezar-agent-orchestrator
弗罗茨瓦夫 Open Mercato 黑客松:#aveCezar 用 Cezar 编排编程智能体
在 Open Mercato 黑客松上,我用 Cezar 做了一次编程智能体编排实验:Machine telemetry、派发上限、cgroup 感知的有效容量和自适应调控器。人在回路,智能体在 Git 工作树里干活。
TLDR:Cezar 就是 ⚡️🚀
周五早上,我只知道有 Cezar 这么个东西。到了周六晚上,我已经有十几个 Git 工作树、一群智能体、一串准备发往上游的 pull request,以及一个正在构建……Cezar 本身的 Cezar。
这大致就是我在弗罗茨瓦夫 Open Mercato 黑客松上那个周末的样子。
我不会假装这是一篇客观的文章。高强度使用2 天之后,我认为 Cezar 是我今年发现的最有意思的工具之一。
先说说 Cezar 到底是什么
Cezar 是一个面向编程智能体的开源编排器。
你不用开5 个终端、5 个 Codex 会话,还费劲记住哪个智能体在做什么,而是得到一个用来并行运行许多任务的控制台。
每个任务都可以有自己的 Git 工作树。任务可以并行工作。多出来的任务在队列里等待。你可以用 Claude Code、Codex、OpenCode 或 pi,用 YAML 构建工作流,接上检查,并实时观看智能体的工作。这里也没有单独的数据库,Cezar 把状态保存在普通的 .ai/cezar/ 文件里。
不过最有趣的部分,要从智能体把工作委派给更多智能体说起。
这个机制就是 派发(Dispatch)。
大致是这样:
Human
  ↓
Lead agent
  ├── child agent
  ├── child agent
  ├── child agent
  └── child agent
Lead 收到一个更大的任务,把它拆解,再把更小的部分委派给它的子智能体。子智能体在各自的 Git 工作树里并行工作,Lead 负责收集结果。
听起来很棒。
直到你开始琢磨:
这些子智能体,我们实际能安全地跑多少个?
问题自己找上门来
在使用 Cezar 的过程中,我很快就到了这样一个点:委派既是它最大的优势,也是一个潜在的问题。
如果一个智能体可以再启动好几个智能体,而它们每一个都在同一台机器上做真实的工作,那你需要的就不只是一句简单的“运行下一个任务”。
你需要的,是对规模的控制。周六晚上,Cezar 的共同创造者之一 Patryk (https://github.com/pat-lewczuk) 把我引向了真正的问题:度量与自动伸缩。我扔掉了那天一直在做的那个功能,因为遥测和自适应控制显然更有价值。
所以第一步是一个简单的机制:
Max running dispatched tasks
人类为派发启动的任务数量设置一个硬性上限。如果上限是 4,那么第五个子智能体不会立刻启动,而是进入队列等待。
普通任务不会被它挡住。
这一点很重要,因为手动上限简单、可预测,而且把最后决定权留给操作者。
我并不打算以后再把它拿掉。
恰恰相反,它成了接下来那些东西的基础。
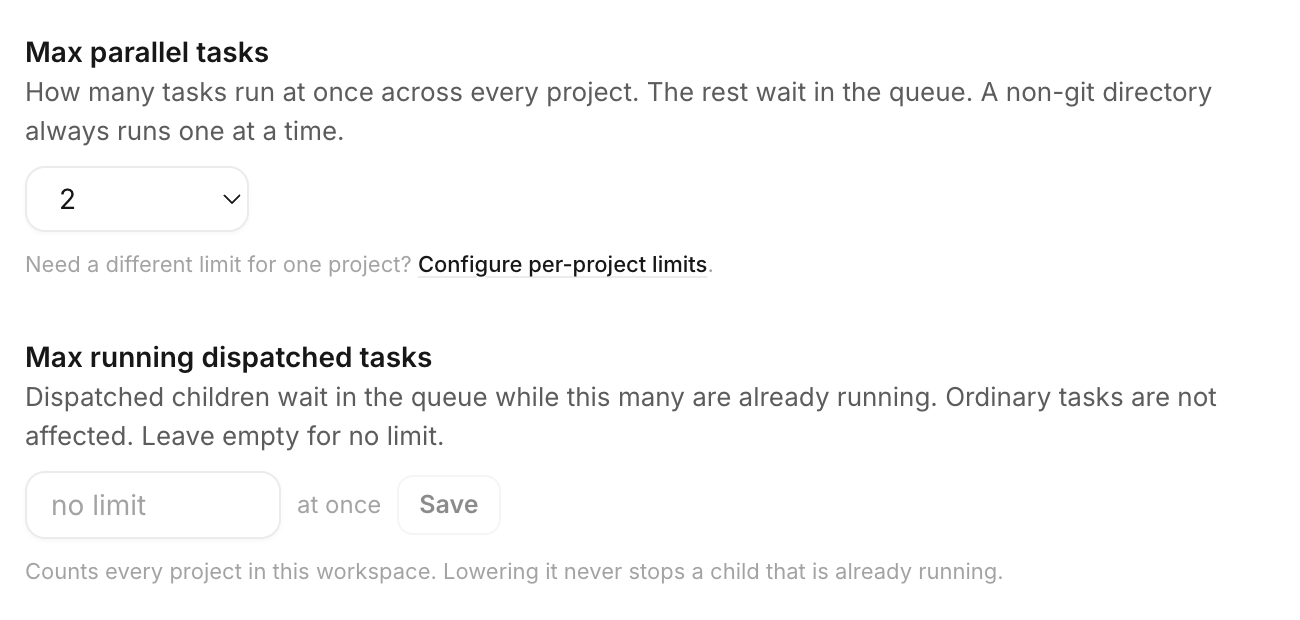
Max parallel tasks 设为 2,而此刻 Max running dispatched tasks 是空的,也就是没有上限。第二个上限只覆盖派发的任务,普通任务照常运行。
来源:写这篇文章期间从 Cezar 截取的截图。
好吧,但这台机器到底能扛多少?
当我进一步思考给智能体设上限这件事时,一个显而易见的问题冒了出来。
一个人到底怎么知道该设 2、4、8 还是 16?
下一个部件就是这么来的:实时的 Machine telemetry。
Resources 里出现了一张卡片,实时显示:
CPU、内存、load average、核心数,以及一小段 CPU 趋势。
没有 Prometheus。
没有 Grafana。
没有额外的遥测智能体。
没有数据库。
只有机器当前的状态。
而仅凭这一点,对我来说就已经非常有用。
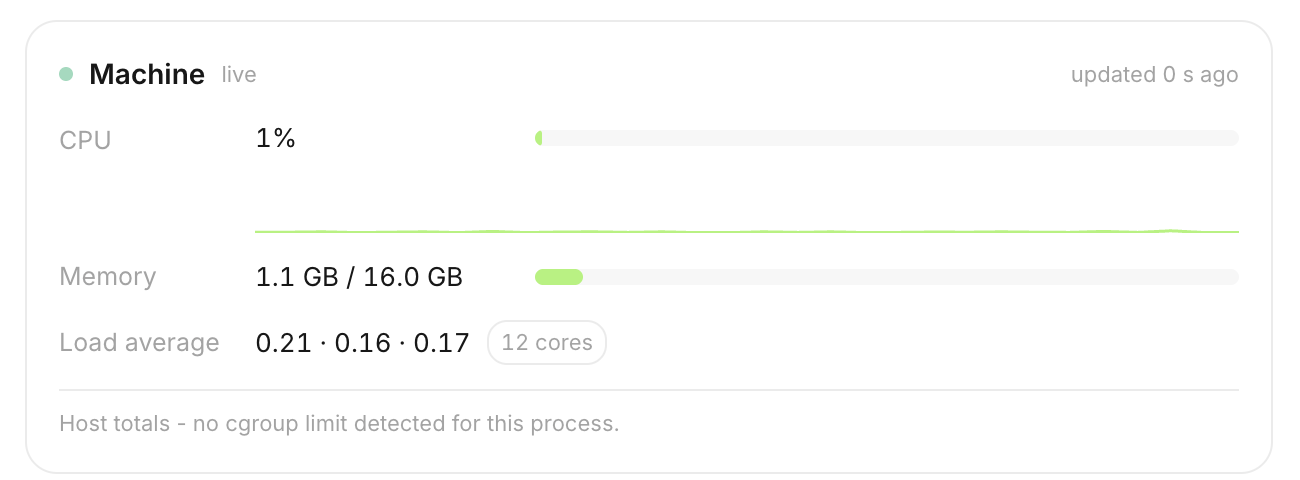
Host totals - no cgroup limit detected for this process. 直说没有检测到这个进程的 cgroup 限制。
来源:Cezar 截图,Machine card v1。
只是片刻之后,一个有意思得多的问题出现了。
宿主机说一套,容器说另一套
第一版遥测显示的是宿主机资源。
在普通机器上这没问题。
但 Cezar 非常适合跑在 VPS、沙箱和容器里。麻烦就出在这里。
宿主机可能有:
24 CPU
58.5 GB RAM
而 Cezar 进程实际能用到的可能只是:
2 CPU
1 GB RAM
如果调度器只看宿主机,一切看起来都很美好。
“放心,我们有 58 GB 内存。”
与此同时,容器正撞上它自己的那 1 GB 上限。
就是在那一刻,一个普通的遥测小部件开始变成有意思得多的东西。
我加入了 cgroup 检测和 有效容量(effective capacity)。
如果进程带着 cgroup 限制运行,Machine card 显示的就是真正适用于这个进程的资源。宿主机总量只作为背景保留可见。
于是一屏之内我们能看到:
effective:
2 CPU
952 MB / 1 GB

host:
24 CPU
58.5 GB RAM
忽然之间,我们手里有了真正可以用来做决定的信息。
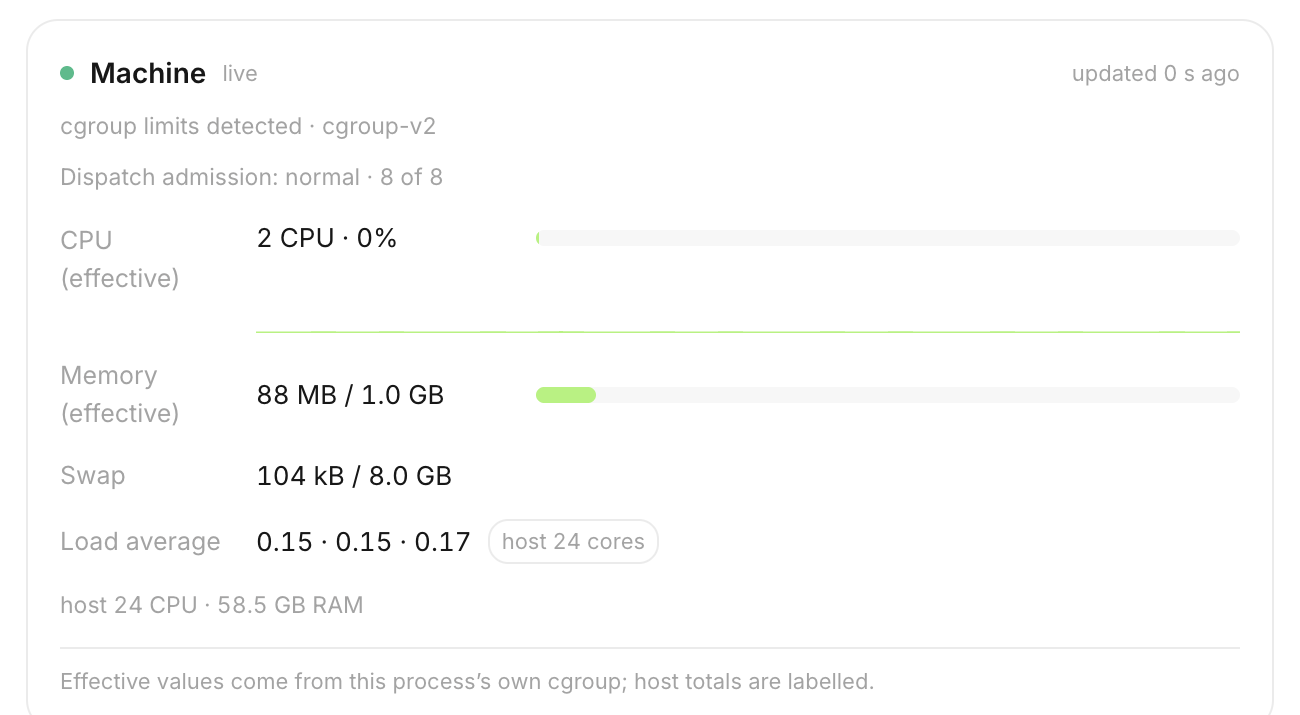
cgroup limits detected - cgroup-v2,有效资源是 2 CPU,以及 1.0 GB 内存中的 88 MB;而宿主机的 24 CPU 和 58.5 GB RAM 退居为背景。现在这个进程看到的是自己的限制,而不是整台机器的资源。
来源:在 2 CPU / 1 GB RAM 容器里从 Cezar 截取的截图。
好吧。既然 Cezar 能看见机器压力……
……那它就不必只是把压力显示出来。
它可以对压力做出反应。
而我最喜欢的那部分,正是从这里开始。
在手动上限之上,我加了一个 自适应调控器。
规则非常简单:
人类设定最大值,自动化只能把上限往下压。
手动上限不会消失。
如果我输入:
Max dispatched tasks = 8那么 8 就是硬性天花板。
调控器不能说:
“你还有很多空闲内存,那我就放 14 个进来”。
不行。
它能做的是看到内存压力,然后说:
“你设的最大值是 8,但现在更安全的是放 4 个进来”。
对我来说,这才是正确的人在回路模型。
human ceiling
      ↓
effective machine capacity
      ↓
adaptive governor
      ↓
dispatch admission
8 -> 4 -> 8
最妙的地方在于,这已经不再是一张架构图了。
它真的有效。
为了测试,我把 Cezar 跑在一个容器里:
2 CPU
1 GB RAM
手动的派发上限:
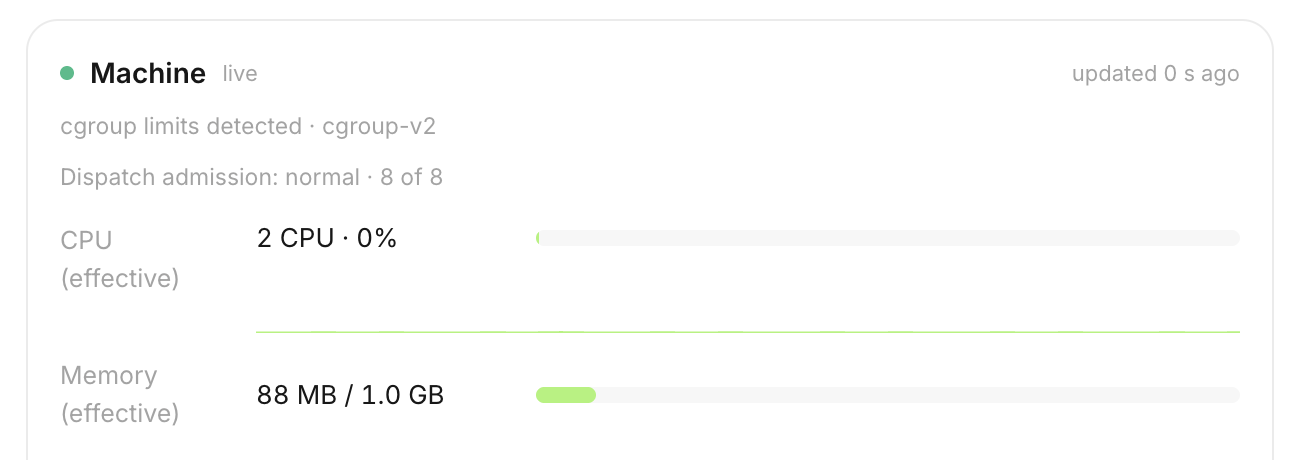
8机器平静时:
Dispatch admission: normal - 8 of 8接着我们把容器的内存压上去。
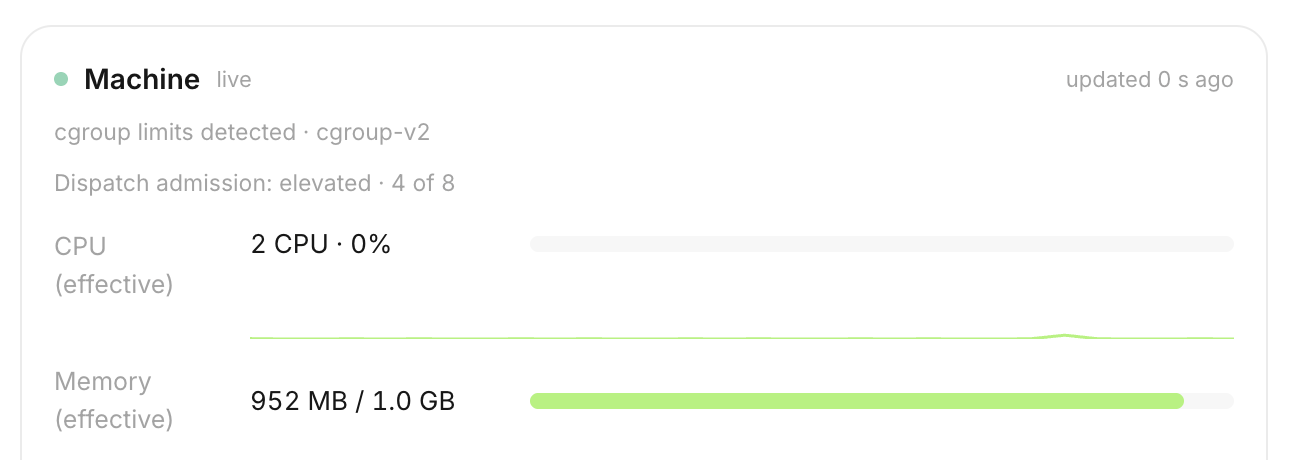
Machine card 会一路爬到大约:
952 MB / 1.0 GB调控器随之移到:
Dispatch admission: elevated - 4 of 8也就是说,它不会改动用户的配置。
它不会停掉已经在运行中的子智能体。
它只是放更少的新任务进来。
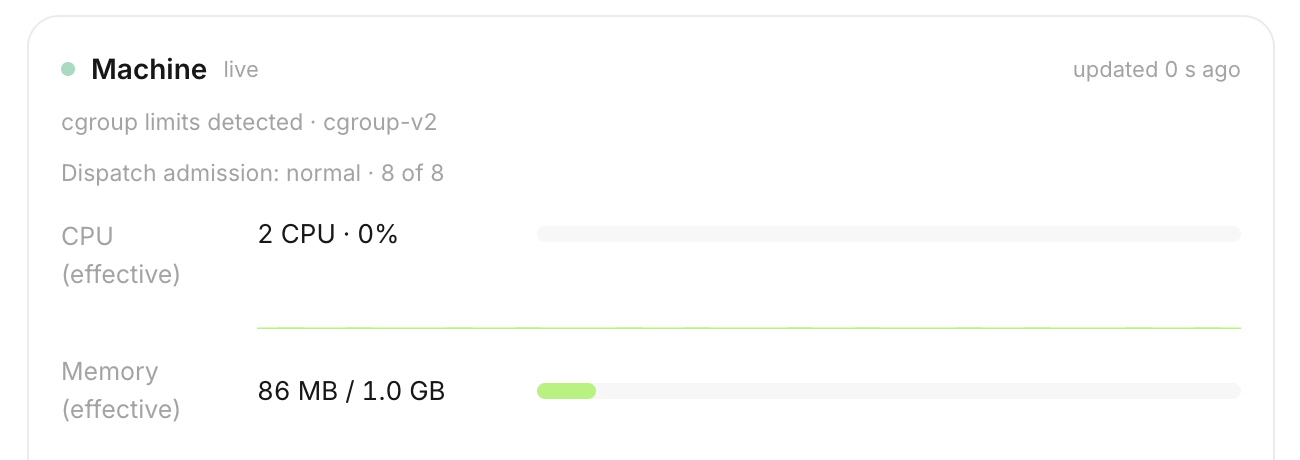
当内存压力消失、系统平静了一会儿之后:
4 -> 8我们又回到了正常的准入。
也就是在那一刻,我心想:
好吧,这个小部件已经不再是小部件了。
它变成了进入编排器控制回路的入口。
用 Cezar 构建 Cezar
整个故事里最 meta 的部分是什么?
这些工作大部分都是用 Cezar 自己完成的。
有一个开发树先后跑过 27 个任务:
1 lead
8 implementation
15 review
3 research
最多有 5 个智能体在并行工作,有一刻我手上有 14 个 Git 工作树。
一个智能体负责实现某个部分。
另一个对它做评审。
再一个做 QA。
评审确实找出了真正的问题,实现被修好,测试重新跑过,然后改动才落进 PR。
有一次,评审抓到了一个很妙的细节:sparkline 显示的是宿主机 CPU %,而它旁边的数字已经代表容器的有效 CPU。
一件小事。
只不过,正是这种小事让遥测变得不再可信。
修复、测试、重新截图,继续前进。
这大概是我从这个周末带走的最大收获。
它已经不只是“AI 会帮我写代码”这件事。
更像是:
idea
↓
lead agent
↓
dispatch
↓
worktrees
↓
implementation
↓
review agents
↓
QA
↓
human
↓
PR
工厂运转起来了。
人类依然守在红色按钮旁边。 😎
我作为开源贡献者的第一个周末
对我个人而言,这次黑客松也是我第一次认真踏入别人的开源项目。
Fork。
分支。
规格说明 PR。
实现 PR。
评审。
CLA。
Rebase。
冲突。
上游。
更多的修复。
而在这一切中间的某个时刻:
“天哪,我的代码真的作为一个还没合并的 PR,躺在我自己在用的项目里”。
这和再做一个属于自己的副项目,感觉非常不一样。
在这里,解决方案要适配的不只是你自己的使用方式。
它还得适配现有的架构、这个项目的理念,以及以后维护它的人。
那 Open Mercato 在这里处于什么位置?
这次黑客松是围绕 Open Mercato 生态组织的。
Open Mercato 是一个用 TypeScript 构建 CRM、ERP 和 电商系统的开源基础框架。项目提供现成的架构决策和基础设施,比如多租户、RBAC、事件和领域模块,让开发者和编程智能体都不必每次都重新造系统的基本轮子。
Cezar 就是从这个生态里长出来的。
这个周末之后,我更加明白其中的原因。
如果你真的想用许多智能体并行构建软件,问题很快就会不再是:
“哪个模型最好?”
而是变成:
我要怎么把这一切管起来?
队列。
Git 工作树。
委派。
评审。
预算。
资源。
准入控制。
人在回路。
而这恰恰是 Cezar 开始变得有意思的地方。
接下来呢?
写这篇文章的时候,我的改动仍然是等待上游评审的开放 PR。
本来就该这样。
开源不是对生产环境执行 git push --force。 😉
不管这些东西最终有多少会以现在的形式落进 main,我已经知道一件事:
Cezar 会留在我的工作流里。
⚡️🚀
EDIT - 21:25,2026 年 9 月 21 日
PS. 让工厂满负荷运转的秘方,是 Open Mercato 的技能合集:
https://github.com/open-mercato/skills
2026 年 9 月 19 日周六,我有幸在弗罗茨瓦夫的 Open Mercato 黑客松上现场观看 Piotr Karwatka 的 live coding 环节。
录像在这里:
https://www.youtube.com/watch?v=VEy3JOwH_ew
目前只有波兰语版本。
Piotr 是 Open Mercato 的联合创始人,也是 Cezar 的共同创造者之一:
https://github.com/pkarw
黑客松产出的 pull request
- #1033 - spec: dispatch admission cap
https://github.com/open-mercato/cezar/pull/1033 - #1034 - implementation: dispatch admission cap
https://github.com/open-mercato/cezar/pull/1034 - #1035 - spec: live host resource telemetry
https://github.com/open-mercato/cezar/pull/1035 - #1036 - implementation: Machine card / host telemetry
https://github.com/open-mercato/cezar/pull/1036 - #1041 - spec: effective capacity / cgroup-aware telemetry
https://github.com/open-mercato/cezar/pull/1041 - #1042 - implementation: effective capacity
https://github.com/open-mercato/cezar/pull/1042 - #1043 - spec: adaptive admission governor
https://github.com/open-mercato/cezar/pull/1043 - #1044 - implementation: adaptive admission governor
https://github.com/open-mercato/cezar/pull/1044
Cezar 仓库:https://github.com/open-mercato/cezar
Open Mercato:https://github.com/open-mercato/open-mercato