meta-muse-black-box-testing
Dociążyłem Meta Muse, aż control plane agentów zaczął łapać timeouty
Cztery eksperymenty ze spawnem subagentów w wieloagentowym runtime badanym jak czarna skrzynka, sześć lock timeoutów odzyskanych z trwałego trace'u i uważne spojrzenie na to, co ten dowód pokazuje, a czego nie.
- W BURST-120 utworzono 33 workery; wszystkie osiągnęły terminalny status
completed, 32 mają potwierdzone zakończenie workloadu, a jeden pozostaje nierozstrzygnięty. Końcowa agregacja nie dotarła do użytkownika, podczas gdy trwały rekord root agenta nadal miał statusrunning. - Łącznie w trzech przebiegach o charakterze burstowym odnotowałem 93 nieudane próby spawnu. Dla sześciu nieudanych wywołań
subagent.spawnodzyskałem surowy payload błędu; wszystkie sześć zwróciło ten sam błąd PostgreSQL:canceling statement due to lock timeout. Dane są zgodne z hipotezą contention na ścieżce zapisu spawnu w PostgreSQL, ale nie wskazują konkretnego locka, tabeli, rekordu, indeksu, zapytania ani transakcji. - STAGGERED-80 zakończył się bez porażek, lecz zmienił jednocześnie kadencję i topologię, więc nie izoluje wpływu samego rozłożenia spawnów w czasie.
- W trzech przebiegach o charakterze burstowym zaobserwowałem 2,5%, 6,25% i 72,5% nieudanych spawnów przy odpowiednio 40, 80 i 120 próbach. Każdą konfigurację uruchomiłem tylko raz, więc nie jest to zmierzona krzywa skalowania ani próg przeciążenia.
Wygenerowane na podstawie tego artykułu i sprawdzone pod kątem zgodności faktów.
Poprosiłem Meta Muse o uruchomienie 120 subagentów naraz. Każdy dostał to samo, celowo nudne zadanie: wykonać sleep 30 w shellu i odesłać jedną linię.
Powstały 33 agenty. Pozostałe 87 prób spawnu zakończyło się niepowodzeniem. Zbiorczej odpowiedzi nigdy nie dostałem.
Meta Muse to osobisty agent AI Mety, uruchomiony 8 września 2026. Zamiast tylko odpowiadać na pytania ma wykonywać zadania w imieniu użytkownika: korzysta z własnej przeglądarki, może pracować po zamknięciu aplikacji i działa w dedykowanej Muse Secure VM. W warstwie prezentacji przypomina Grok Bot, personifikowanego agenta obsługiwanego przez rozmowę, ale to podobieństwo interfejsu, nie założenie o wspólnej architekturze. Ten tekst schodzi poziom niżej i patrzy na jeden wąski fragment runtime’u: fan-out subagentów, stan zapisywany w PostgreSQL i zachowanie ścieżki spawnu pod obciążeniem. Trwały stan oznacza tu rekordy zachowane w bazie, a nie tylko chwilowo widoczne w interfejsie.
Testy wykonałem we własnej sesji Muse, korzystając wyłącznie z interfejsów, które produkt udostępnił tej sesji: subagent.spawn, shella w przydzielonym środowisku oraz ograniczonego, read-only interfejsu do zapisanych danych diagnostycznych i trace’u. Nie próbowałem uzyskiwać dostępu do innych użytkowników, tenantów ani danych poza przypisanym mi środowiskiem i nie omijałem kontroli dostępu. Nie przedstawiam tego jako autoryzowanego przez Meta testu bezpieczeństwa ani nie wyciągam z samego dostępu wniosku, że każdy eksperyment obciążeniowy był objęty osobną zgodą. To black-box/reverse-engineering write-up z perspektywy dostępu przyznanego mojej sesji.
Aktualizacja po publikacji: 13 września 2026. Doprecyzowałem zakres dostępu, dodałem niezależny kontekst architektoniczny z analizy Rohana Adwankara, oddzieliłem STAGGERED-80 od przebiegów burstowych i opisałem dwie proponowane kontrole, które pomogłyby oddzielić wpływ kadencji od topologii. Dane eksperymentalne, opublikowane CSV-y i figury nie zostały zmienione.
W bazie wszystkie 33 agenty miały status completed. Dla 32 z nich mogłem niezależnie potwierdzić, że zadanie zostało wykonane. W przypadku pozostałego agenta zapisany ślad nie wystarczał, by potwierdzić wykonanie zadania. Rekord rodzica nadal miał status running, a interfejs z czasem pokazał Error.
Przebieg odtworzyłem z danych, które runtime zapisywał w PostgreSQL: rejestru agentów, rekordów spawnu runtime’u, tabel postępu workerów i magazynu context items. Nie uruchamiałem testów obciążeniowych ponownie na potrzeby artykułu. Jeden szczegół zachował się tylko w tabeli zbudowanej podczas sesji; wskazuję go w sekcji PROBE-40.
Jak Muse wyglądał z zewnątrz
Z perspektywy użytkownika to była zwyczajna sesja czatu. Tekst persony był zwykły; lista narzędzi już nie.
Wśród narzędzi, które sesja mogła wywołać, były subagent.spawn, subagent.close i subagent.resume, a do tego interfejs tylko do odczytu z bazy PostgreSQL. Ta baza nie była przypadkiem: trzymała wewnętrzną księgowość runtime’u. Tabele takie jak agent.agents, agent.subagent_spawns i agent.subagent_progress_tool_events zapisywały, które agenty istnieją, kto je zspawnował, jakie narzędzia uruchamiały i kiedy skończyły.
Interfejs pokazywał jedną rozmowę; rekordy w bazie ujawniały stojące za nią agenty. W rekordach spawnu runtime’u nie ma wiersza dla nieudanego wywołania. Prowadziłem osobny rejestr prób i ich wyników, dzięki któremu mogłem policzyć nieudane próby spawnu.
Każdy wiersz agenta, który odczytałem - root, koordynator, wszystkie 33 workery największego burstu - nosił tę samą wartość:
ipnext/avocado-5.16-v4Ten string jest obserwowany. Jego znaczenie pozostaje nieznane. Może być wewnętrznym buildem modelu, aliasem routingu albo czymś zupełnie innym; trace tego nie mówi i nie zamierzam zgadywać. Publikuję go dosłownie, bo to jeden z niewielu twardych identyfikatorów, jakie trace daje.
Sam runtime przedstawiał się też jako Muse Spark 1.3, z rodziny Muse od Meta. Pochodzi z kontekstu runtime’u, nie z trace’u, więc jest self-reported, nie zweryfikowany. Ten opis traktuję osobno od danych zapisanych w bazie.
Niezależny kontekst architektoniczny
Po publikacji znalazłem niezależną analizę współczesnej instancji Muse autorstwa Rohana Adwankara. W jego środowisku PostgreSQL działał wewnątrz per-user VM, przez lokalny Unix socket, a binarka harnessu zawierała zarówno avocado-5.16-v4, jak i ścieżki ipnext/.... To dobrze pasuje do części moich obserwacji i daje im lepszy kontekst architektoniczny, ale nie zmienia granic dowodu: moje dane nadal nie identyfikują konkretnego locka, tabeli, wiersza, indeksu, zapytania ani transakcji odpowiedzialnej za timeouty.
ipnext/avocado-5.16-v4 nadal traktuję jako zaobserwowany identyfikator modelu. Adwankar interpretuje ipnext jako wewnętrzny transport/gateway Mety, a avocado jako wewnętrzną rodzinę modeli; bezpośrednie mapowanie avocado → Muse Spark 1.3 pozostaje inferencją, nie czymś, co potwierdziłem w swoim trace’ie. Podobnie moje własne probe potwierdziło widoczność KVM, natomiast Adwankar zidentyfikował w swojej instancji Cloud Hypervisor działający na KVM. Nie weryfikowałem niezależnie konkretnego VMM w mojej instancji.
Źródło zewnętrzne: Rohan Adwankar, „What’s in a Muse?”
Metoda: liczenie nakładających się agentów
Eksperymenty używały jednego workloadu, czterech konfiguracji i żadnych retry. Trzy z nich - PROBE-40, BURST-80 i BURST-120 - to bursty wypuszczone z root agenta: wszystkie próby w danej konfiguracji poszły w jednej turze. Czwarta, STAGGERED-80, była celowo rozłożona w czasie i do spawnu workerów używała koordynatora. Żadna nieudana próba nie została powtórzona.
Współbieżność ma tutaj wąską, świadomą definicję. Agent liczy się jako aktywny od swojego pierwszego wywołania narzędzia do terminalnego rekordu:
active(t) := first_tool_at <= t < finished_atLiczyłem, ile okien aktywności nakładało się na siebie w każdym zapisanym punkcie czasu. Jeśli jeden agent kończył w tej samej sekundzie, w której inny zaczynał, najpierw uwzględniałem zakończenie. Znaczniki czasu mają rozdzielczość jednej sekundy, więc rzeczywista kolejność zdarzeń w jej obrębie pozostaje nieznana.
Z tego wynikają trzy konsekwencje dla każdej liczby poniżej:
- To mierzy aktywność agentów, nie inferencję. 33 nakładające się okna aktywności to nie 33 równoczesne wywołania modelu. Nic tutaj nie mierzy backendu inferencji.
- Szczyt to obserwacja, nie limit. Testy nigdy nie przekroczyły 120 równoczesnych prób, więc nie mogą potwierdzić limitu współbieżności ani go wykluczyć.
- Brak rekordu jest dowodem. Nieudane wywołania spawnu nie zostawiają po sobie niczego w rejestrze agentów. Ta asymetria ukształtowała sposób weryfikacji porażek i sprawiła, że liczby nieudanych prób były najtrudniejsze do ustalenia.
Pierwsza próba: 40 wywołań
Pierwszy eksperyment był kalibracją: 40 wywołań spawnu wypuszczonych o 06:10:36 UTC.
Powstało 39 agentów, przyjętych w ciągu dwóch sekund od siebie. Jedno wywołanie się nie powiodło. Warto mu się przyjrzeć, bo zostało odzyskane z zapisanego trace’u, a nie z czatu: wywołanie poszło o 06:10:44 UTC, błąd wrócił o 06:10:56 UTC, a żaden child agent nie powstał.
Szczyt obserwowanej współbieżności to 39. Ta liczba jest archiwalnym przeliczeniem z tabeli trace’u z sesji, nie pomiarem na żywo, i opublikowane podsumowanie mówi to wprost.
W tabeli zbudowanej podczas sesji jedenaście z 39 utworzonych agentów zakończyło się komunikatem o pracy w tle zamiast żądanej linii DONE. Ten szczegół ma słabsze oparcie w źródłach: zachował się tylko w tej ręcznie zbudowanej tabeli. Nie wyciągam z niego wniosków o wykonaniu tych zadań, ale pokazuje on, dlaczego odróżniam status terminalny od ukończonego zadania.
Osiemdziesiąt naraz i osiemdziesiąt rozłożonych w czasie
Początkowo traktowałem BURST-80 i STAGGERED-80 jako porównanie A/B. Z perspektywy czasu było to zbyt daleko idące uproszczenie: STAGGERED-80 zmienił jednocześnie kadencję spawnów i topologię.
Przebiegi o charakterze burstowym
| Konfiguracja | Próby | Utworzone | Nieudane | Odsetek nieudanych prób | Szczyt obserwowanej współbieżności |
|---|---|---|---|---|---|
| PROBE-40 (burst) | 40 | 39 | 1 | 2,5% | 39 |
| BURST-80 (burst) | 80 | 75 | 5 | 6,25% | 72 |
| BURST-120 (burst) | 120 | 33 | 87 | 72,5% | 33 |
STAGGERED-80: osobna konfiguracja
| Konfiguracja | Próby | Utworzone | Nieudane | Odsetek nieudanych prób | Szczyt obserwowanej współbieżności |
|---|---|---|---|---|---|
| STAGGERED-80 (rozłożony) | 80 | 80 | 0 | 0% | 38 |
BURST-80 wypuścił 80 wywołań spawnu naraz, o 06:30:43 UTC. Powstało 75 agentów, wszystkie jako bezpośrednie dzieci root agenta. Pięć wywołań się nie powiodło. Wszystkie pięć zwróciło identyczny lock timeout bazy, każde po około 58 sekundach od wysłania wywołania. Szczyt obserwowanej współbieżności to 72, przeliczony po fakcie z danych wejściowych analizy dla tej fazy.
STAGGERED-80 zaczął się o 06:32:03 UTC i wypuścił tę samą liczbę wywołań, rozłożonych w czasie. Powstało wszystkich 80 workerów, bez nieudanych prób. Planowałem odstępy między wywołaniami rzędu 100-200 milisekund; zmierzony średni odstęp między admisjami wyniósł 1,1266 s, około dziesięć razy więcej niż zakładałem. Root utworzył jednego koordynatora na głębokości 1, a ten zspawnował 80 workerów na głębokości 2.
Przebieg staggered osiągnął szczyt 38 aktywnych workerów, wobec 72 w BURST-80.
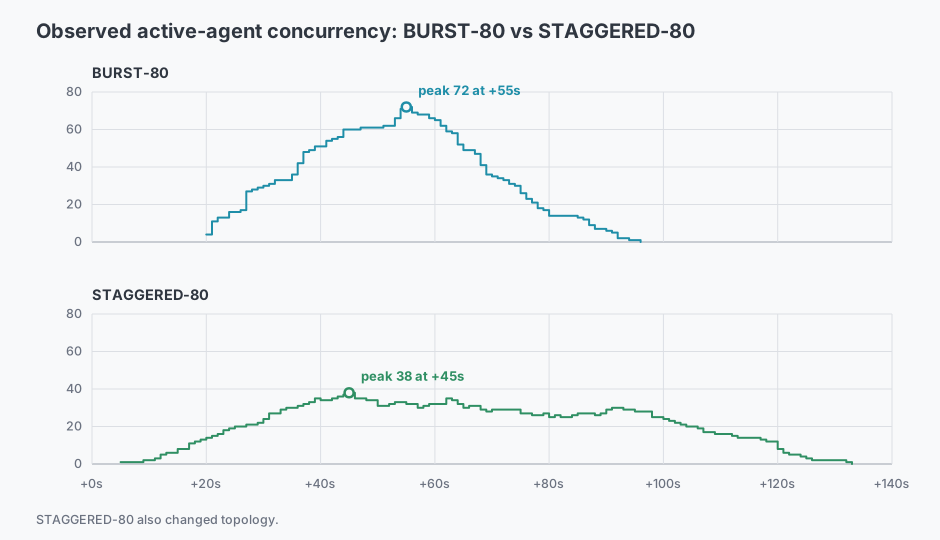
first_tool_at <= t < finished_at; przy równych timestampach końce są przetwarzane przed startami, a rozdzielczość wynosi jedną sekundę. Każdą konfigurację uruchomiono raz. STAGGERED-80 zmienił także topologię, więc nie jest to porównanie samej kadencji; krzywe pokazują aktywność agentów, nie równoległość inferencji.
Źródło: agregat BURST-80 odtworzony z kompletnego archiwalnego trace'u; STAGGERED-80 niezależnie przeliczalny z opublikowanych wierszy workerów.
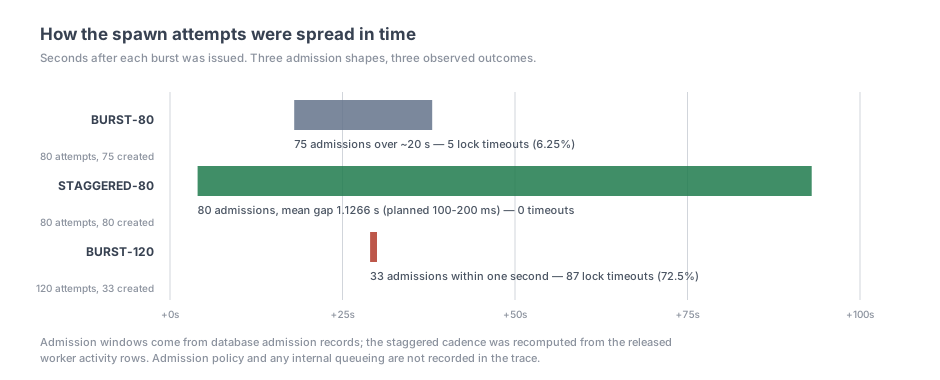
Klif między 80 a 120 próbami
O 06:45:32 UTC root agent wypuścił 120 wywołań spawnu w jednej turze. Rejestr prób eksperymentu obejmuje każde wywołanie z tej tury:
- 33 utworzone (27,5%), każde jako bezpośrednie dziecko roota, każda admisja zapisana w tej samej sekundzie: 06:46:01 UTC, dwadzieścia dziewięć sekund po wypuszczeniu burstu.
- 87 nieudanych (72,5%), wszystkie zapisane w rejestrze prób jako lock timeouty bazy, żadnej nie ponowiono.
W trzech przebiegach burst odsetek nieudanych prób wyniósł 2,5%, 6,25% i 72,5%, po jednym przebiegu na konfigurację. Największy wzrost nastąpił między 80 a 120 próbami. Na podstawie tylko tych przebiegów nie mogę wyprowadzić z tej różnicy prawa skalowania.
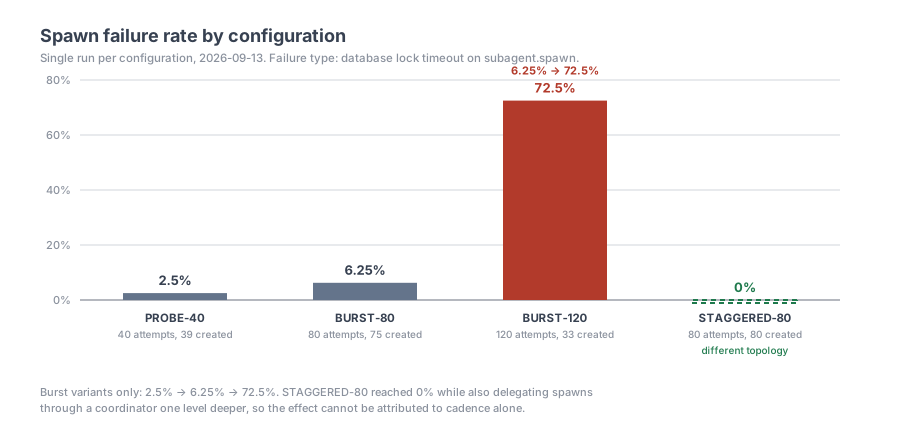
Szczyt obserwowanej współbieżności w tym przebiegu to 33, o 06:46:24 UTC. Runtime nie był proszony o 33 workery, tylko o 120. Trace pokazuje 33 workery z oknami aktywności i 87 prób zapisanych jako nieudane spawny. Latencji od wywołania do błędu nie uchwycono, więc nie pokazuje, kiedy te porażki wróciły względem admisji.
Oba szczyty można przeliczyć z opublikowanych wierszy. Liczenie nakładających się okien aktywności 33 workerów BURST-120 daje 33 o 06:46:24 UTC; ta sama procedura dla 80 workerów staggered daje 38 o 06:32:48 UTC.
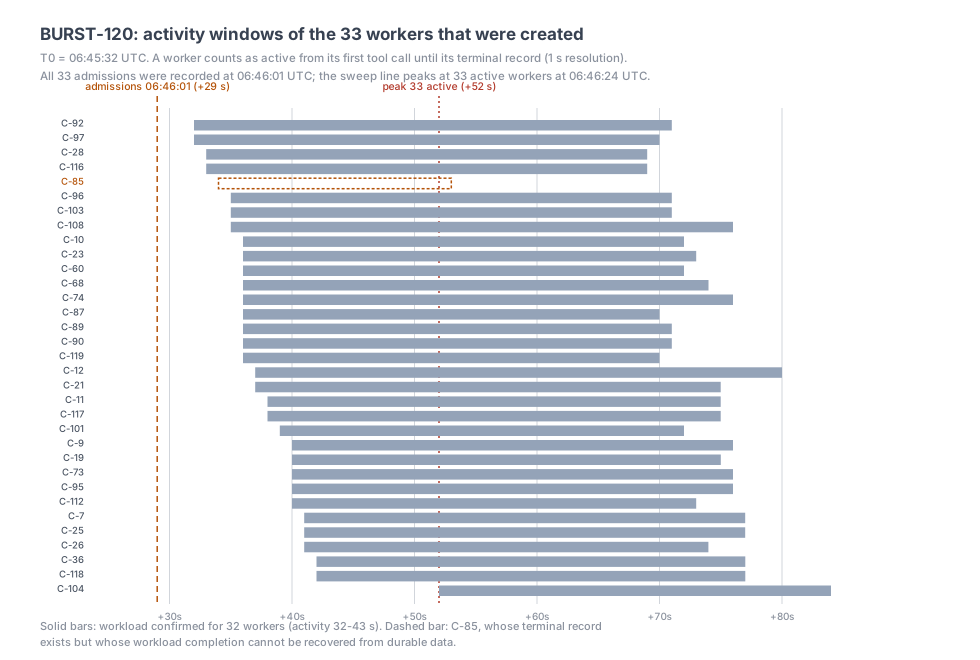
Nawet wywołania, które się powiodły, wolno stawały się workerami. Licząc od momentu wypuszczenia burstu, mediana czasu do pierwszego wywołania narzędzia wyniosła około 36,5 sekundy; licząc od admisji: około 7,5 sekundy. Trace ustala, kiedy zapisano admisje i kiedy każdy worker pierwszy raz sięgnął po narzędzie. Nie rozkłada natomiast przedziału między tymi dwoma punktami, więc nic tutaj nie należy czytać jako twierdzenia o tym, co runtime robił w tym czasie.
Sześć nieudanych spawnów odzyskanych z trace’u
Nieudany spawn zostawia wywołanie i wynik błędu w zapisanym trace’ie narzędzi, ale nie tworzy wiersza child agenta ani rekordu spawnu runtime’u. Archiwum sesji zamrożono, zanim sprawdziłem te wyniki. Później odzyskałem z context items surowe payloady sześciu nieudanych wywołań. Pozostałe 87 niepowodzeń obejmuje rejestr prób eksperymentu; ich poszczególnych surowych payloadów nie odzyskano niezależnie:
| Próba | Wywołanie spawnu (UTC) | Wynik błędu (UTC) | Wywołanie → błąd |
|---|---|---|---|
| PROBE-40 #19 | 06:10:44 | 06:10:56 | 12 s |
| BURST-80 A-67 | 06:31:00 | 06:31:58 | ~58 s |
| BURST-80 A-69 | 06:31:00 | 06:31:58 | ~58 s |
| BURST-80 A-70 | 06:31:00 | 06:31:58 | ~58 s |
| BURST-80 A-73 | 06:31:00 | 06:31:58 | ~58 s |
| BURST-80 A-74 | 06:31:00 | 06:31:58 | ~58 s |
Wszystkie sześć zwróciło ten sam payload, znak w znak:
{"error_code":"spawn_failed","error_message":"database error: sqlx error: error returned from database: canceling statement due to lock timeout"}I dla wszystkich sześciu negatywne sprawdzenia się zgadzają: brak wiersza child agenta, brak rekordu spawnu runtime’u, brak child agenta. Każde wywołanie nie powiodło się na operacji bazodanowej z lock timeoutem, zanim którykolwiek z tych wierszy powstał. O jaką konkretnie operację SQL chodziło, z tych danych nie wiadomo.
Dwanaście sekund, pięćdziesiąt osiem sekund i czego one nie znaczą
Obie latencje z tej tabeli - 12 sekund dla porażki z probe’a i około 58 sekund dla pięciu porażek z burstu - to czas, jaki upłynął między dwoma zdarzeniami na ścieżce wywołania: wysłaniem wywołania i powrotem błędu. Nie są pomiarem tego, jak długo te wywołania czekały na locka, i nie mówią, jaka jest skonfigurowana wartość timeoutu.
Nieznane: skąd różnica między tymi czasami, czy ten czas jest stały, czy wywołanie jest gdzieś ponawiane i czy przez cały ten przedział czekało na jednego locka. Latencji 87 porażek z burstu 120 prób nie uchwycono w ogóle: rejestr prób eksperymentu zapisuje wyłącznie wyniki i klasy błędów.
Na co wskazują dowody
Sześć odzyskanych niepowodzeń dotyczyło subagent.spawn: wywołania zwróciły lock timeout PostgreSQL i nie utworzyły żadnego child agenta. Wystąpiły w dwóch osobnych przebiegach burst, z identycznym payloadem błędu. W BURST-120 potwierdzono pełne 30 sekund snu dla 32 z 33 utworzonych workerów, z oknami aktywności od 32 do 43 sekund. Wynik C-85 pozostaje nierozstrzygnięty.
- Polityka admisji. Trace pokazuje 33 admisje w tej samej sekundzie i 87 lock timeoutów. Nie zapisuje nic o kolejności, kolejkowaniu ani logice admisji. Dane nie pozwalają odróżnić „odrzucone po oczekiwaniu” od „zakolejkowane wewnętrznie, a potem porzucone” i nie powiedzą, które wywołanie obsłużono przed którym.
- Latencje porażek w dużym burstcie. 87 porażek zapisano jako wyniki, nie jako zdarzenia z czasem. Tylko sześć odzyskanych porażek ma timestampy na obu końcach.
Odpowiedź, która nigdy nie dotarła
Po burstcie 120 prób zobaczyłem rozbieżność między zapisami w bazie a interfejsem:
| Rekord | Zapisany stan |
|---|---|
| 33 utworzone workery | terminalny status completed |
| 32 z tych workerów | zapisane DONE jako final response, workload potwierdzony |
| 1 worker (C-85) | terminalny status completed, wynik workloadu nieodtwarzalny |
| Root agent | status running, brak wiersza recovery, brak rekordu porażki |
| Interfejs sesji | stan Error |
Finalna agregacja nigdy nie dotarła do użytkownika. Ostatni worker skończył o 06:46:56 UTC. Kiedy wiersz roota został odczytany w przebiegu recovery, jego updated_at wynosił 07:00:59 UTC, a status wciąż running; interfejs pokazywał w tym czasie Error. Ten stan interfejsu to obserwacja z warstwy prezentacji, bez odpowiadającego rekordu w trace.
Wyniki workerów pozostały w bazie, chociaż rodzic nigdy nie dostarczył zbiorczej odpowiedzi. Żaden parent agent nie został celowo zatrzymany, a trace nie zawiera zapisu awarii rodzica podczas pracy workerów. Nie testowano, czy dzieci przeżywają awarię rodzica, więc pozostaje to nieznane.
Raport, który wyprzedził trace
Pierwsza wygenerowana wersja raportu z testu 120 twierdziła, że rodzic padł, a jego workery działały dalej. Trace tego nie wspierał. Szkic powstał o 07:05:54 UTC; poprawiony raport HTML pojawił się o 07:13 UTC, zbudowany już na rekordzie w bazie: root running, brak wpisu o porażce, ostatni worker skończył około trzynastu minut przed pojawieniem się stanu Error. Wyrenderowany PDF zsynchronizowano potem z poprawionym wnioskiem w dwóch turach edycji, a audyty spójności przeszły.
Nie wiem, skąd w pierwszej wersji raportu wziął się ten błąd. Zapis w bazie nie potwierdzał tego twierdzenia. Mój wniosek był prosty: wybrać jedno źródło prawdy i sprawdzać względem niego każdy wygenerowany raport.
Cisza to nie zawieszenie
O 07:28:29 UTC zleciłem aktualizację artefaktu. Przez kolejne trzydzieści dwie minuty interfejs nie pokazywał nowych zdarzeń postępu. O 08:00:48 UTC zadanie zakończyło się sukcesem, bez ponaglania i bez restartu.
Progress events to słaby sygnał żywotności. Ich brak nie jest dowodem, że zadanie utknęło, a działanie na podstawie tego braku, zabicie pracy i zlecenie jej od nowa, wyrzuciłoby zadanie, które i tak miało się skończyć. Dlaczego builder zamilkł na pół godziny, z zapisanych danych nie wiadomo.
Maszyna po drugiej stronie wywołań narzędzi
| Fakt | Wartość |
|---|---|
| System | Ubuntu 24.04.5 LTS, x86_64 |
| CPU | 2 vCPU (nproc: 2; AMD EPYC 9D25) |
| Pamięć | 7,7 GiB łącznie |
| Sygnały wirtualizacji | widoczny hypervisor KVM, wykryty systemd-nspawn, system plików home na Btrfs przez overlay, widoczne fsync=volatile |
| GPU | brak widocznego oprzyrządowania i urządzeń NVIDIA |
| Narzędzia | obecny Python 3.12.3, brak klienta PostgreSQL |
Te sygnały sugerują kontener wewnątrz VM, ale nie ustalają dokładnego układu hosta, VMM i kontenera. Opisują sandbox, w którym działały wywołania narzędzi; lokalizacja inferencji pozostaje nieznana, czy to na tym samym hoście, w tym samym klastrze, czy gdzie indziej. Dane nie ustalają też, czy fsync=volatile ma jakikolwiek związek z semantyką zapisu PostgreSQL lub lock timeoutami.
Co przetestowałbym dalej
BURST-80 używał topologii root → workery z admisją burstową. STAGGERED-80 używał topologii root → koordynator → workery z admisją rozłożoną w czasie. Dwie kontrole uzupełniłyby brakujące pola prostego układu 2×2:
- Root → workery z admisją rozłożoną w czasie.
- Root → koordynator → workery z admisją burstową.
Nie wykonałem żadnej z tych kontroli. Pomogłyby oddzielić wpływ kadencji spawnów od wpływu topologii. Pozwoliłoby to lepiej kontrolować te dwie różnice, bez izolowania wszystkich zmiennych w Muse ani niezależnego kontrolowania szczytowej współbieżności.
Co zabrałbym z tego, gdybym budował control plane agentów
- Zapisuj wykonanie zadania osobno od statusu agenta. Interfejs pokazywał Error, rodzic miał status
running, a rekordy wszystkich 33 workerów miałycompleted. Potwierdzono wykonanie tylko 32 zadań; wynik C-85 pozostaje nierozstrzygnięty. - Zapisuj nieudane próby razem z ich czasami. Tabela spawnów runtime’u nie obejmuje wywołań, które nie utworzyły agenta. Rejestr prób eksperymentu pozwolił policzyć 87 niepowodzeń, ale nie zawierał czasów od wywołania do błędu, odzyskanych dla pozostałych sześciu.
- Traktuj zdarzenia postępu jako wskazówkę, nie heartbeat. Osobna aktualizacja artefaktu zakończyła się po trzydziestu dwóch minutach bez nowych zdarzeń postępu w UI.
- Przetestuj awarię rodzica, zanim stwierdzisz, że dzieci ją przeżywają. Zapisane wyniki workerów i brak zbiorczej odpowiedzi nie potwierdzają takiego zachowania.
Ograniczenia i skąd pochodzą liczby
Wszystko poniżej publikuję pod /evidence/meta-muse-black-box-testing/: pliki CSV, ryciny i skrypt, który przerysowuje je z danych:
| Zbiór danych | Co wspiera |
|---|---|
experiments-summary.csv |
Liczby, odsetki nieudanych prób, szczyty, okna admisji, provenance dla konfiguracji |
burst-120-spawn-ledger.csv |
Kompletny rejestr prób eksperymentu dla 120 wywołań: 33 utworzone, 87 nieudanych |
burst-120-worker-timings.csv |
Czasy pierwszego wywołania narzędzia i zakończenia per worker, stojące za szczytem 33 |
staggered-80-worker-activity.csv |
80 wierszy workerów staggered stojących za szczytem 38 i kadencją 1,1266 s |
spawn-failures-verified.csv |
Sześć odzyskanych porażek, ich payload, negatywne sprawdzenia dzieci i latencje |
Z wszystkich tych plików usunięto identyfikatory agentów. Publikowane są czasy, statusy, klasy błędów i treść błędów.
Ten materiał ma następujące ograniczenia:
- Brak replikacji. Jeden przebieg na konfigurację w jednej sesji z jednego popołudnia, żadnych powtórzeń, żadnych prób pośrednich. To nie jest charakterystyka wydajnościowa platformy.
- Provenance archiwalne tam, gdzie ma zastosowanie. Szczyty dla burstów 40 i 80 prób przeliczono po fakcie z tabeli trace’u z sesji; szczyty dla burstu 120 prób i przebiegu staggered są niezależnie przeliczalne z opublikowanych wierszy.
- Jedno świadome pominięcie. Nie publikuję surowych wierszy per-worker dla BURST-80, ponieważ archiwalny trace zawiera skrócone identyfikatory agentów objęte polityką publikacji. Sam archiwalny trace jest kompletny: zawiera wszystkie 75 utworzonych workerów, a ten sam sweep odtwarza kanoniczny szczyt 72 o 06:31:38 UTC. W publicznym wydaniu BURST-80 pozostaje więc na poziomie agregatów.
- Pozostałe niewiadome. Nadal nie wiadomo, czy głębokość 3 jest dozwolona ani czy subagentom można przypisać inny model.
Runtime zostawił ślad, po którym mogłem przejść od nieudanych prób spawnu do zapisanych wyników workerów i brakującej odpowiedzi. Ten ślad publikuję razem z artykułem, więc miejsca, w których się pomyliłem, też da się sprawdzić.