meta-muse-black-box-testing
我持續壓測 Meta Muse,直到它的 AI 代理控制平面開始逾時
在一個黑箱式多代理執行階段上做了四組子代理生成實驗,從它的持久化追蹤中還原出6 次資料庫鎖定逾時,並仔細檢視這些證據能說明什麼、不能說明什麼。
我請 Meta Muse 一次生成 120 個子代理。每個子代理都拿到同一個刻意無聊的工作:在 shell 裡執行 sleep 30,然後送回一行結果。
最後建立了 33 個代理,其餘 87 次生成嘗試全都失敗。我始終沒有拿到彙總後的答案。
Meta Muse 是 Meta 在 2026 年 9 月 8 日推出的個人 AI 代理。它不只是回答問題,還被設計成能代替使用者執行任務:它有自己的瀏覽器,應用程式關閉後仍能繼續工作,並在專屬的 Muse Secure VM 裡執行。就呈現方式而言,它很像 Grok Bot,一個透過對話控制的擬人化代理,但這只是介面層級的類比,並不是在假定兩者共用同一套架構。本文再往下探一層,檢視執行階段中一個很窄的部分:子代理扇出、它存在 PostgreSQL 裡的狀態,以及負載下的生成路徑。這裡所謂的持久狀態,指的是存進資料庫的記錄,而不是介面上一閃即逝的狀態。
這些測試都在我自己的 Muse 工作階段裡進行,只使用該工作階段能存取的介面:subagent.spawn、分配環境中的一個 shell,以及一個範圍受限、唯讀的介面,用來讀取已儲存的診斷與追蹤資料。我沒有嘗試存取其他使用者、其他租戶,或分配給我的環境之外的資料,也沒有繞過存取控制。我不會把它當成一份經 Meta 授權的安全性評估,而且單憑有存取權,不足以證明每一次負載實驗都分別獲得授權。這是一篇黑箱測試與逆向工程的紀錄,出發點是我的工作階段所取得的存取權。
發布後更新:2026 年 9 月 13 日。 我釐清了存取範圍,補上 Rohan Adwankar 分析所提供的獨立架構脈絡,把 STAGGERED-80 與突發式測試分開陳述,並描述了兩組建議的對照,用來更清楚區分節奏與拓撲。實驗資料、已發布的 CSV 與圖表都沒有更動。
資料庫把全部 33 個代理都標記為 completed。其中 32 個,我能獨立確認工作負載已經跑完。剩下那一個,已儲存的追蹤不足以驗證工作負載是否完成。父記錄仍然寫著 running,而介面最後顯示 Error。
我從執行階段寫入 PostgreSQL 的記錄重建了這次測試:代理註冊表、執行階段的生成記錄、依 worker 分開的進度資料表,以及一個 context item 儲存區。為了寫這篇文章,我沒有重跑這些負載測試。有一個細節只留在工作階段期間手工建立的一張資料表裡;我會在 PROBE-40 那一節指出它。
從外面看,Muse 長什麼樣子
從使用者的角度來看,這就是一次普通的對話工作階段。角色設定文字很平淡,工具清單卻不是。
這個工作階段能呼叫的工具包括 subagent.spawn、subagent.close 和 subagent.resume,另外還有一個連向 PostgreSQL 資料庫的唯讀介面。那個資料庫不是配角:它保存著執行階段自己的內部記錄。agent.agents、agent.subagent_spawns 和 agent.subagent_progress_tool_events 這類資料表,記錄了有哪些代理存在、誰生成它們、它們執行過哪些工具,以及它們何時結束。
介面只顯示一段對話;資料庫記錄卻揭示了它背後的代理。執行階段的生成記錄裡,沒有任何一列對應失敗的呼叫。我另外維護了一份嘗試與結果的紀錄表,這樣才數得出失敗的生成嘗試。
我讀到的每一列代理記錄,包括根代理、協調者,以及最大一次突發裡的全部 33 個 worker,都帶著同一個值:
ipnext/avocado-5.16-v4這個字串是觀察到的,它的意義則不是。它可能是內部的模型建置、路由別名,或完全是別的東西;追蹤沒有交代,我也不打算猜。我原樣發布它,因為這是追蹤提供的少數幾個確切識別碼之一。
這個執行階段也自稱是 Muse Spark 1.3,屬於 Meta 的 Muse 系列。這個說法來自執行階段自己的脈絡,而不是追蹤,所以它是自我陳述,未經驗證。我把這項描述與資料庫證據分開看待。
獨立的架構脈絡
文章發布後,我找到 Rohan Adwankar 對一個同期 Muse 實例所做的獨立拆解。在他的環境裡,PostgreSQL 是透過本機 Unix socket 在使用者專屬的 VM 內執行,而執行框架(harness)二進位檔中同時包含 avocado-5.16-v4 和 ipnext/... 路徑。這與我的若干觀察相符,也為它們提供了有用的架構脈絡,但沒有改變證據的邊界:我的資料仍然無法指出是哪個特定的鎖定、資料表、資料列、索引、查詢或交易造成這些逾時。
我仍然把 ipnext/avocado-5.16-v4 當成一個觀察到的模型識別碼。Adwankar 把 ipnext 解讀為 Meta 內部的傳輸/閘道層,把 avocado 解讀為內部模型系列;把 avocado 直接對應到 Muse Spark 1.3 仍然只是推論,不是我的追蹤所確立的事。同樣地,我自己的探查確立了 KVM 的可見性,而 Adwankar 則在他自己的實例中辨識出跑在 KVM 上的 Cloud Hypervisor。我沒有獨立確立我的實例用的是哪個 VMM。
外部來源:Rohan Adwankar,「What’s in a Muse?」
方法:計算重疊的代理
這些實驗只用了一種工作負載、四種組態,而且沒有重試。其中三種,也就是 PROBE-40、BURST-80 和 BURST-120,是從根代理發出的突發式測試:同一種組態裡的每一次嘗試都在同一輪送出。第四種 STAGGERED-80 則刻意分散在時間上,並用一個協調者代理來生成它的 worker。沒有任何失敗的呼叫被重複。
這裡的並行有一個刻意收窄的定義。一個代理從第一次工具呼叫開始,到它的終端記錄為止,都算作活躍:
active(t) := first_tool_at <= t < finished_at我統計在每一個記錄到的時間戳記上,有多少個這樣的活動視窗互相重疊。如果一個代理結束和另一個代理開始落在同一秒,我會先把結束計入。時間戳記的解析度是一秒,所以同一秒內真正的順序是未知的。
以下每一個數字都要搭配這三點來看:
- 這裡量測的是代理活動,不是推論。 33 個重疊的活動視窗不等於 33 次同時發生的模型呼叫。這裡沒有任何東西在量測推論後端。
- 峰值是一種觀察,不是上限。 這些測試從未超過 120 次同時嘗試,因此既無法確立並行上限,也無法排除它。
- 記錄從缺本身就是證據。 失敗的生成呼叫不會在代理註冊表裡留下任何東西。這種不對稱決定了失敗必須怎麼驗證,也是失敗次數最難確定下來的原因。
第一次探查:40 次呼叫
第一個實驗是一次校準測試:在 06:10:36 UTC 發出 40 次生成呼叫。
它建立了 39 個代理,彼此的准入時間相差不到2 秒。有一次呼叫失敗,而這次失敗值得細看,因為它是從已儲存的工具追蹤還原出來的,不是從對話裡讀來的:呼叫在 06:10:44 UTC 送出,錯誤在 06:10:56 UTC 回來,而且沒有建立任何子代理。
觀察到的並行峰值是 39。這個數字是從工作階段的追蹤資料表事後重算出來的,不是即時量測,已發布的摘要也這麼說。
工作階段期間建立的一張資料表顯示,39 個已建立的代理裡有 11 個結束時送出的是「背景處理中」的狀態訊息,而不是被要求的 DONE 那一行。這個細節的出處比較弱:它只留在那張手工建立的資料表裡。我不會因此對那些工作負載下任何結論,但它說明了為什麼我會把終端狀態和已完成的工作區分開。
一次 80 個,以及錯開的 80 個
我一開始把 BURST-80 和 STAGGERED-80 當成一組 A/B 對照。回頭看,這個判斷太寬容了:STAGGERED-80 同時改變了生成節奏和拓撲。
突發式測試
| 組態 | 嘗試次數 | 已建立 | 失敗 | 失敗率 | 觀察到的並行峰值 |
|---|---|---|---|---|---|
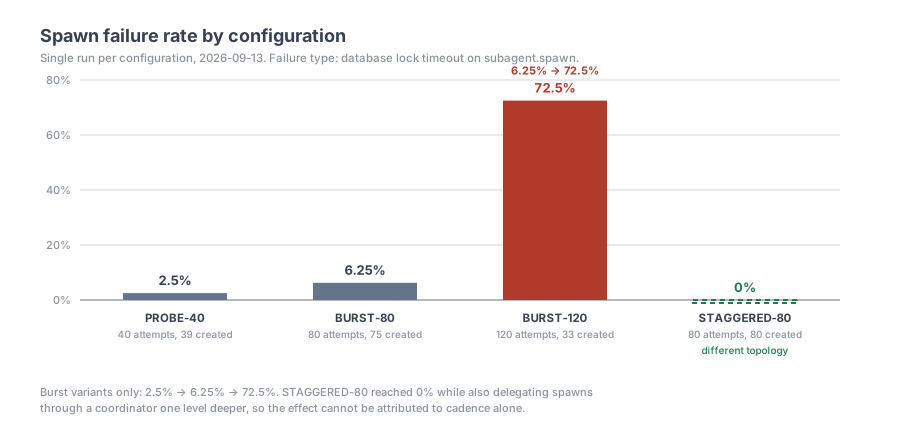
| PROBE-40(突發) | 40 | 39 | 1 | 2.5% | 39 |
| BURST-80(突發) | 80 | 75 | 5 | 6.25% | 72 |
| BURST-120(突發) | 120 | 33 | 87 | 72.5% | 33 |
STAGGERED-80:另一種獨立組態
| 組態 | 嘗試次數 | 已建立 | 失敗 | 失敗率 | 觀察到的並行峰值 |
|---|---|---|---|---|---|
| STAGGERED-80(錯開) | 80 | 80 | 0 | 0% | 38 |
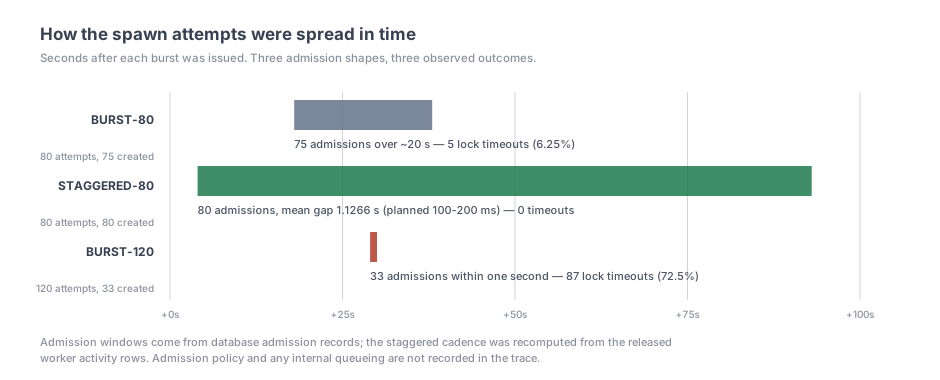
BURST-80 在 06:30:43 UTC 一次發出 80 次生成呼叫。建立了 75 個代理,全部都是根代理的直接子代理。有五次呼叫失敗。這五次都回傳完全相同的資料庫鎖定逾時,而且各自在呼叫送出後約 58 秒才回來。觀察到的並行峰值是 72,這是測試結束後依該階段的分析輸入重算出來的。
STAGGERED-80 在 06:32:03 UTC 開始,發出同樣數量的呼叫,但彼此錯開。它建立了全部 80 個 worker,沒有一次失敗。我原本打算讓呼叫間隔 100-200 毫秒;實測的平均准入間隔是 1.1266 秒,大約是計畫值的10 倍。根代理在深度 1 生成了一個協調者,後者再在深度 2 生成這 80 個 worker。
這次錯開式測試的活躍 worker 峰值是 38,而 BURST-80 是 72。
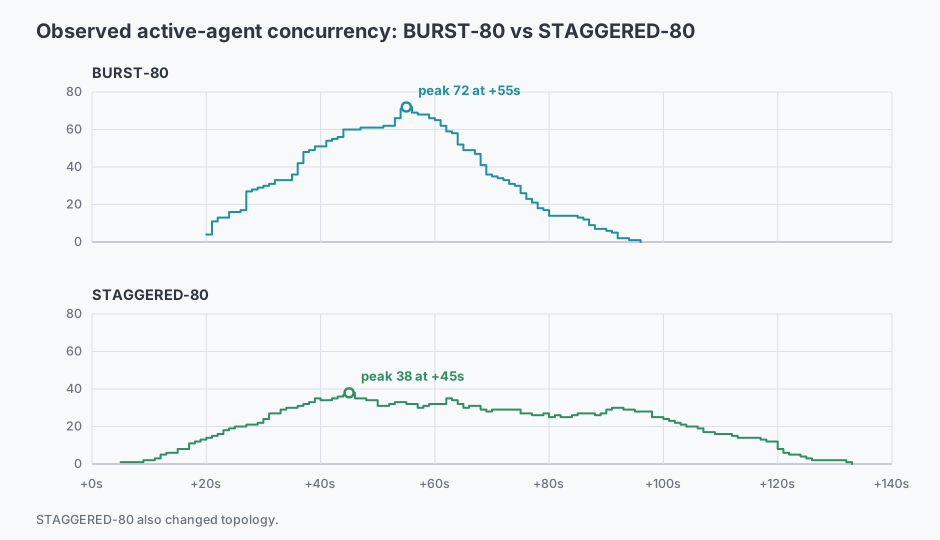
first_tool_at <= t < finished_at,時間戳記相同時先處理結束、再處理開始;時間戳記的解析度是一秒。每一種組態都只跑了一次。STAGGERED-80 還改變了拓撲,所以這不是只比較節奏;曲線顯示的是代理活動,不是推論並行。
來源:BURST-80 的彙總資料由完整封存的追蹤重建;STAGGERED-80 可從已發布的 worker 資料列獨立重算。
80 與 120 之間的斷崖
在 06:45:32 UTC,根代理在同一輪裡發出 120 次生成呼叫。實驗的嘗試紀錄表涵蓋那一輪的每一次呼叫:
- 建立了 33 個(27.5%),每一個都是根代理的直接子代理,每一次准入都記錄在同一秒:06:46:01 UTC,也就是突發送出後 29 秒。
- 失敗 87 個(72.5%),在嘗試紀錄表裡全部記為資料庫鎖定逾時,沒有任何一次重試。
在三次突發式測試中,觀察到的失敗率分別是 2.5%、6.25% 和 72.5%,每一種組態各跑一次。增幅最大的一段出現在 80 到 120 次嘗試之間。手上只有這幾次測試,我沒辦法把這個差異變成任何速率定律。
這次測試中觀察到的並行峰值是 33,出現在 06:46:24 UTC。執行階段被要求的不是 33 個 worker,而是 120 個。追蹤顯示出來的是 33 個帶有活動區間的 worker,以及 87 次被記錄為生成失敗的嘗試。這些嘗試從呼叫到錯誤的延遲沒有被捕捉,所以追蹤看不出那些失敗相對於准入是什麼時候回來的。
兩個峰值都可以從已發布的資料列重算。對 33 個 BURST-120 worker 統計重疊的活動視窗,在 06:46:24 UTC 得到 33;對 80 個錯開式 worker 套用同樣的步驟,在 06:32:48 UTC 得到 38。
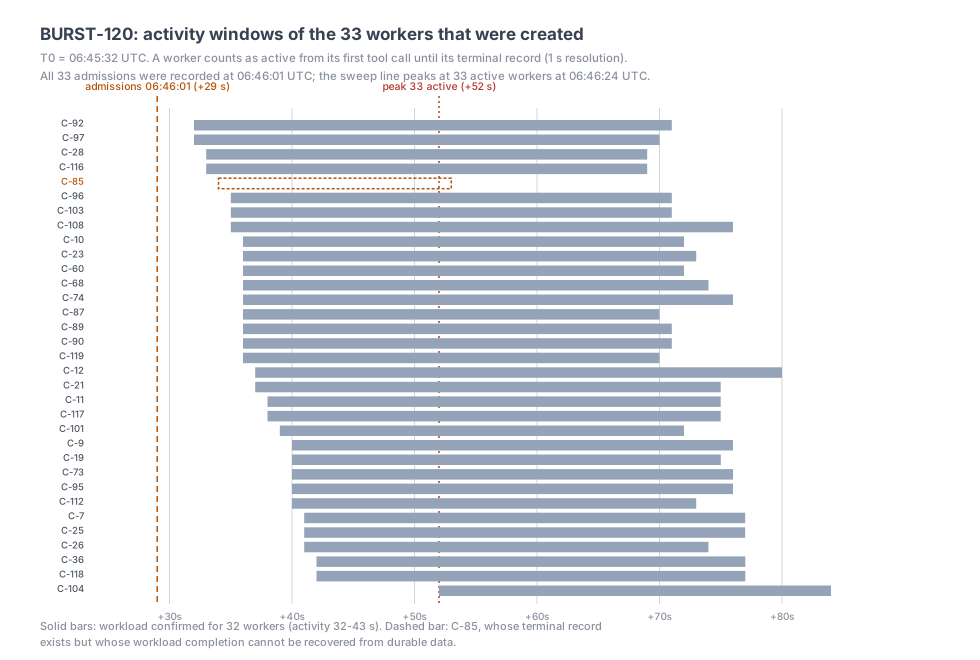
即使是成功的呼叫,也要過一段時間才真的變成 worker。從突發送出的那一刻算起,已建立的 worker 到達第一次工具呼叫的中位數約為 36.5 秒;從准入那一刻算起,中位數約為 7.5 秒。追蹤確立了准入是什麼時候被記錄的,以及每個 worker 第一次呼叫工具是什麼時候。它沒有拆解這兩點之間的區間,所以這裡沒有任何內容應該被解讀成在說執行階段那段時間裡做了什麼。
從工具追蹤還原的6 次失敗
一次失敗的生成會把呼叫與錯誤輸出留在已儲存的工具追蹤裡,但不會建立任何子代理資料列,也不會建立執行階段的生成資料列。工作階段的封存在我檢查那些輸出之前就已經凍結。後來我從 context item 裡還原了6 次失敗呼叫的原始 payload。實驗的嘗試紀錄表涵蓋另外 87 次失敗;它們各自的原始 payload 並沒有被獨立還原:
| 嘗試 | 生成呼叫 (UTC) | 錯誤結果 (UTC) | 呼叫 → 錯誤 |
|---|---|---|---|
| PROBE-40 #19 | 06:10:44 | 06:10:56 | 12 s |
| BURST-80 A-67 | 06:31:00 | 06:31:58 | ~58 s |
| BURST-80 A-69 | 06:31:00 | 06:31:58 | ~58 s |
| BURST-80 A-70 | 06:31:00 | 06:31:58 | ~58 s |
| BURST-80 A-73 | 06:31:00 | 06:31:58 | ~58 s |
| BURST-80 A-74 | 06:31:00 | 06:31:58 | ~58 s |
這6 次回傳的 payload 逐字元完全相同:
{"error_code":"spawn_failed","error_message":"database error: sqlx error: error returned from database: canceling statement due to lock timeout"}而且這6 次的否定性查核結果都一致:沒有子代理資料列、沒有執行階段的生成資料列、沒有子代理。每次呼叫都是在帶有鎖定逾時的資料庫操作上失敗,而且都發生在那些資料列出現之前。從這些資料無法得知涉及的是哪一個 SQL 操作。
12 秒、58 秒,以及它們並不代表什麼
表中這兩個延遲,探查失敗的 12 秒和五次突發失敗的約 58 秒,都是呼叫路徑上兩個事件之間的經過時間:呼叫送出,以及錯誤回來。它們不是對這些呼叫等了鎖定多久的量測,也沒有告訴我們設定的逾時值是多少。
未知的有:這些時間長度為什麼不同、這個時間長度是否固定、呼叫是否在別的地方被重試,以及這些呼叫是否整段時間都在等同一個鎖定。120 次嘗試那次突發中,87 次失敗的延遲完全沒有被捕捉:實驗的嘗試紀錄表只記錄結果和錯誤類別。
證據指向什麼
6 次還原出來的失敗都發生在 subagent.spawn 上,回傳 PostgreSQL 鎖定逾時,而且沒有建立任何子代理。它們出現在兩次不同的突發式測試中,錯誤 payload 完全相同。在 BURST-120 裡,33 個已建立的 worker 中有 32 個被確認完整跑完 30 秒的 sleep,活動視窗為 32 到 43 秒。C-85 仍然沒有定論。
- 准入政策。 追蹤顯示 33 次准入發生在同一秒,以及 87 次逾時。它沒有記錄任何關於排序、排隊或准入邏輯的資訊。這份資料無法區分「等待後被拒絕」和「在內部排隊後又被丟棄」,也無法告訴你哪一次呼叫先被處理。
- 大型突發的失敗延遲。 這 87 次失敗被記錄成結果,而不是有時間的事件。只有6 次還原出來的失敗在兩端都有時間戳記。
始終沒有送達的答案
120 次嘗試的突發之後,我發現已儲存的記錄和介面之間不一致:
| 記錄 | 記錄到的狀態 |
|---|---|
| 33 個已建立的 worker | 終端狀態 completed |
| 其中 32 個 worker | 儲存了 DONE 最終回應,工作負載已確認 |
| 1 個 worker(C-85) | 終端狀態 completed,工作負載結果無法還原 |
| 根代理 | 狀態 running,沒有復原負責人的資料列,沒有失敗記錄 |
| 工作階段介面 | Error 狀態 |
最終的彙總結果始終沒有送到使用者手上。最後一個 worker 在 06:46:56 UTC 結束。復原過程中讀取根資料列時,它的 updated_at 是 07:00:59 UTC,狀態仍然是 running;介面大約在那個時間顯示 Error。那個介面狀態是呈現層的觀察,追蹤裡沒有對應的記錄。
即使父代理從未送出彙總答案,worker 的結果仍然留在資料庫裡。沒有父代理被刻意設成失敗,而追蹤也沒有記錄到 worker 執行期間出現父層失敗。子代理是否能在父層失敗後繼續存活,沒有測試過,因此未知。
一份跑在追蹤前面的報告
那份 120 次嘗試報告的第一個生成版本,斷言父代理已經失敗,而它的 worker 還繼續在跑。追蹤並不支持這種說法。草稿產出於 07:05:54 UTC;07:13 UTC 出現了修正後的 HTML 報告,改以資料庫記錄為依據:根代理 running、沒有失敗條目、最後一個 worker 在 Error 狀態出現前約 13 分鐘結束。接著渲染出來的 PDF 經過兩輪編輯,與修正後的結論同步,一致性稽核全部通過。
我不知道第一版草稿為什麼會弄錯。已儲存的追蹤並不支持那個說法。我的心得很簡單:選定一個事實來源,然後用它核對每一份生成的報告。
沉默不等於卡住
在 07:28:29 UTC,我請求更新一份產出物。接下來 32 分鐘,介面沒有顯示任何新的進度事件。08:00:48 UTC,任務成功完成,沒有再提示,也沒有重新啟動。
進度事件是一種很弱的存活訊號。它們從缺,並不構成任務卡住的證據;而根據這種從缺採取行動,把工作砍掉再重新發出,等於丟掉一個本來就要完成的任務。builder 為什麼安靜了半小時,從已儲存的資料裡無法得知。
工具呼叫另一頭的那台機器
| 事實 | 值 |
|---|---|
| 作業系統 | Ubuntu 24.04.5 LTS, x86_64 |
| CPU | 2 vCPU(nproc:2;AMD EPYC 9D25) |
| 記憶體 | 總計 7.7 GiB |
| 虛擬化訊號 | 可見 KVM hypervisor、偵測到 systemd-nspawn、家目錄檔案系統透過 overlay 位於 Btrfs 上、可見 fsync=volatile |
| GPU | 看不到任何 NVIDIA 工具或裝置 |
| 工具 | 有 Python 3.12.3,未安裝 PostgreSQL 用戶端 |
這些訊號暗示這是一個跑在 VM 裡的容器,但無法確立主機、VMM 與容器的確切組合方式。它們描述的是工具呼叫所執行的沙盒;模型推論的位置仍然未知,不論是在同一台主機、同一個叢集或別的地方。這些資料也無法確立 fsync=volatile 是否與 PostgreSQL 的儲存語意或鎖定逾時有任何關係。
我接下來會測試什麼
BURST-80 採用根代理 → worker 的拓撲,配突發式准入。STAGGERED-80 採用根代理 → 協調者 → worker 的拓撲,配錯開式准入。兩組對照可以補上一個簡單 2×2 設計裡缺的格子:
- 根代理 → worker,配錯開式准入。
- 根代理 → 協調者 → worker,配突發式准入。
這兩組對照我都沒有跑。 它們能幫忙把生成節奏的影響和拓撲的影響分開。這樣可以更乾淨地控制這兩個差異,同時不必隔離 Muse 裡的每一個變數,也不必獨立控制並行峰值。
如果我親手打造代理控制平面,我會帶走什麼
- 把任務完成與代理狀態分開記錄。 介面顯示 Error,父代理顯示
running,而全部 33 個 worker 記錄都顯示completed。只有 32 個工作負載獲得確認;C-85 仍然沒有定論。 - 把失敗的嘗試連同時間一起記錄下來。 執行階段的生成資料表無法涵蓋那些沒有建立任何代理的呼叫。實驗的嘗試紀錄表數出了 87 次失敗,卻缺少另外6 次已還原的呼叫到錯誤耗時。
- 把進度事件當成提示,而不是心跳。 那次獨立的產出物更新在 32 分鐘沒有新的介面進度事件之後完成了。
- 在宣稱子代理能挺過父層失敗之前,先測試父層失敗。 儲存下來的 worker 結果和從缺的彙總答案,並不能確立這種行為。
限制,以及這些數字從哪裡來
以下所有內容都發布在 /evidence/meta-muse-black-box-testing/:CSV 檔、圖表,以及依資料重繪這些圖表的腳本:
| 資料集 | 它能佐證什麼 |
|---|---|
experiments-summary.csv |
各種組態的計數、失敗率、峰值、准入視窗與出處 |
burst-120-spawn-ledger.csv |
120 次呼叫的完整實驗嘗試紀錄表:33 個已建立、87 個失敗 |
burst-120-worker-timings.csv |
支撐 33 個 worker 峰值的各 worker 首次工具呼叫與結束時間 |
staggered-80-worker-activity.csv |
支撐 38 個 worker 峰值與 1.1266 秒節奏的 80 列錯開式 worker 資料 |
spawn-failures-verified.csv |
6 次已還原的失敗、它們的 payload、子代理從缺的否定性查核,以及延遲 |
所有這些檔案都移除了代理識別碼。發布出來的是時間、狀態、錯誤類別和錯誤文字。
這些證據有以下限制:
- 沒有重複實驗。 每一種組態只在某個下午的一次工作階段裡跑一次,沒有重複,也沒有中間的嘗試次數。這不是對平台效能的特性描述。
- 在適用的地方註明封存出處。 40 次與 80 次突發的峰值是事後從工作階段的追蹤資料表重算的;120 次突發與錯開式測試的峰值,則可以從已發布的資料列獨立重算。
- 一處刻意的省略。 我不發布 BURST-80 的原始各 worker 資料列,因為封存的追蹤裡含有發布政策涵蓋的縮短代理識別碼。封存的追蹤本身是完整的:它包含全部 75 個已建立的 worker,用同一套掃描可以在 06:31:38 UTC 重算出標準峰值 72。因此 BURST-80 在公開發布中仍保持彙總形式。
- 其他未知項。 深度 3 是否被允許,以及子代理是否能指定不同的模型,都仍然未知。
這個執行階段留下一條線索,讓我能從失敗的生成嘗試一路追到已儲存的 worker 結果和那個從缺的答案。這條線索隨本文一併發布,所以我弄錯的部分也可以被查核。