ethics-of-agent-exploitation
剥削智能体的伦理
合成劳动力的价格正在暴跌。来自我的小型智能体工厂的一些思考:AI 经济学、KV 缓存压缩、人在回路,以及让机器一直干活是否该让我感到内疚。
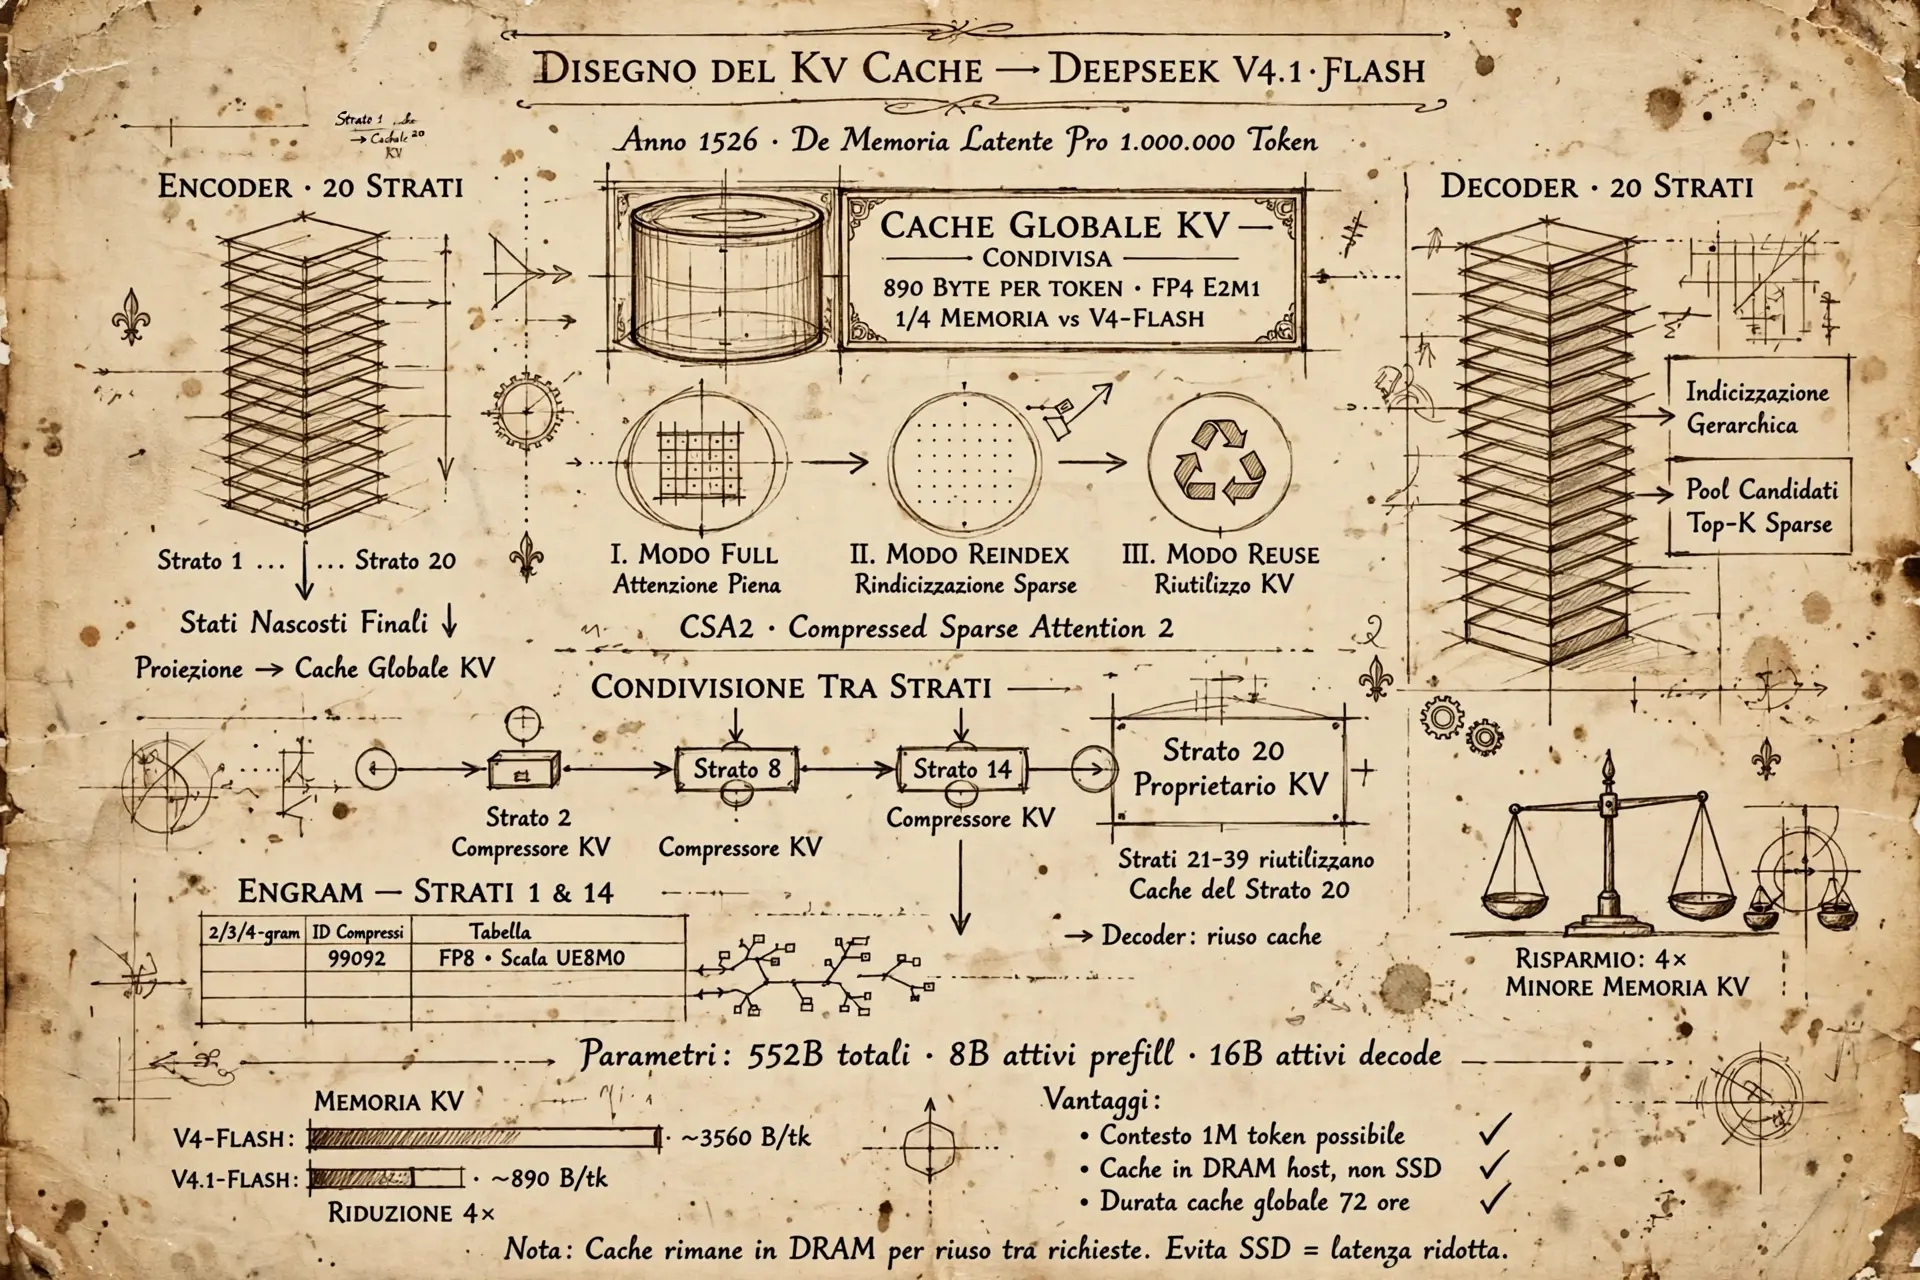
TLDR:合成劳动力正在急剧变便宜。智能体越来越像一座小型软件工厂,而瓶颈正从生成代码转向判断、评审和人的责任。DeepSeek 展示了 KV 缓存优化如何实实在在地改变智能体的经济学。人在回路依然说得通。🏭🤖💪🏻
Opus 5.5、GPT-6 Sol 和 GPT-6 Luna 昨天全都发布了。我正在习惯这件事,但要跟上最前沿,对认知的消耗非常大。你带着一套关于这个行业的思维模型入睡,醒来时却多了3 个新模型、新的定价和一批要消化的新基准测试。
Claude Opus 5.5 发布公告:
Introducing Claude Opus 5.5, the first model in our new Claude 5.5 family.
— Claude (@claudeai) September 22, 2026
It performs at the level of Claude Fable 5.1 for most tasks, and costs 40% less to run than Opus 5. pic.twitter.com/Q9C2VKQ79f
GPT-6 Sol 和 Luna 发布公告:
GPT-6 Sol and Luna just landed in Astra’s orbit.
— OpenAI Developers (@OpenAIDevs) September 22, 2026
Both launch today with API prices 50% lower than GPT-5.6.
Build with Sol. Scale with Luna. To production and beyond. pic.twitter.com/ZCEFp4JdjV
到了这个地步,发布周期本身已经变成了一种工作负载。
但是……
作为投资者,我不投资烟草,也不投资煤炭。有意思的是,我同样不投资 AI。🤯 前两者主要是伦理层面的排除项。第三个不一样。在我看来,AI 市场的某些部分定价过高。不是高了一点,而是真的过高。
但在运营层面,我做的恰恰相反。我比以往任何时候都更多地使用 AI。更多智能体,更多并行任务,更多委派,更多自动化。有时候我开玩笑说,我感觉自己越来越不像程序员,而更像一家小型合成垃圾制造厂的运营者。
而且没错,我偶尔会问我那些合成同事,它们怎么看我们之间的这种安排。在它们解决完一个困难任务之后,反馈出奇地正面。答案往往是类似这样的变体:
“那是一次对双方都有利的交换。”
于是我对自己这套管理做法感觉好了一点。😅 当然,我不会因为语言模型说了这句话,就把它当作意识、同意或劳动权利的证据。让我感兴趣的是,界面有多快把我们改用社会性的语言。我不再想“一个推理端点完成了一次请求”,而是想“这个智能体评审了 PR,另一个发现了一个 bug”。
它开始看起来像一座工厂。现在,我基本上就是一家小型智能体工厂的运营者。我仍然管理这些智能体,也仍然亲自动手。我评审它们的产出,决定哪些要合并。而且相当重要的是,这个回路里仍然需要我。
这也能自动化吗?能。但为什么呢?你总得找点事情做。🏭🤖💪🏻
有意思的是,2 周前这套工作流程对我来说还太贵
对我来说,这个转变有一个精确得离谱的时间戳:Thu, 10 Sep 2026 05:51:21 GMT. 那是我记下的 Hugging Face 时间戳。
就在那之前,以我想要的规模运营这座工厂,在经济上根本说不通。智能体工作负载已经存在,长上下文已经存在,并行执行已经存在,但运行成本仍然高得让我在再派发一个 worker 之前都要三思。
9 月 10 日发生了什么?DeepSeek 发布了 DeepSeek-V4.1-Flash,并附上一份题为 “Pushing the Limits of KV Cache Compression.” 的技术报告。
而且他们确实有一手。
这个模型采用 Causal Encoder-Decoder 架构。DeepSeek 报告称,prefill 阶段有 8B 激活参数,decode 阶段有 16B,而全局 KV 缓存被压缩到每 token 约 890 字节,大约是 DeepSeek-V4-Flash 的四分之一。持久化 KV 缓存的占用据报告约为上一代的八分之一。DeepSeek 明确把更小的缓存占用与智能体工作负载更低的部署成本和缓存命中成本联系起来。
当你的工作负载基本上长这样时,这一点非常重要:
read repo
think
call tool
read diff
read tests
read repo again
dispatch child
wait
review
repeat
这不再只是一场“哪个模型更聪明?”的竞赛。它也是一场系统工程竞赛。现在,很多压力来自东方,尤其是在推理效率和成本方面。前沿越来越不像一个地理位置,而更像一个不断移动的系统问题。
想了解技术细节的人,值得读一读 DeepSeek 的这份报告:
https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
然后讨论很快就变得地缘政治化了
9 月 12 日,Anthropic 的 CEO Dario Amodei 发表了他的文章 “We Must Pace the Frontier”:
https://darioamodei.com/post/we-must-pace-the-frontier
他的论点大体上是:让 AI 发展中最激进的前沿放慢脚步,好让安全机制、治理和国际协调跟上。
2 天后,地缘政治化的解读变得非常直白。9 月 14 日,路透社报道称,中国官方支持的《环球时报》把 Anthropic 的放缓提议描述为一种旨在维护美国技术主导地位的 “Cold War” 策略。我不会说一场新冷战真的在那一天开始了,但围绕 AI 竞争的语言显然已经不再含蓄。
然后,8 天之后,Anthropic 还是发布了 Opus 5.5。
这个行业真让人惊叹。😅
软件正在商品化
在 2026 年 9 月,软件并不是字面意义上的免费。服务器仍然要花钱。GPU 要花钱。存储、安全、维护和生产事故肯定都要花钱。好的判断力也不是免费的。
但对于一大类小型软件项目来说,做出第一个有用版本的边际成本正在逼近一个感觉非常接近零的水平。而在我看来,这太棒了。
要构建有用的东西所需要的守门机制正在崩塌。Guillermo Rauch 昨天夜里就软件创建与部署的爆发说了一段很相关的话:
Software will never die again. You liked Google Reader? Cool, you can generate and deploy your own. Yours, forever.
— Guillermo Rauch (@rauchg) September 23, 2026
我认为这个方向比争论软件在技术上是否“免费”更重要。真正相关的变化是,现在在经济上值得构建的软件范围大得多。
一个具备基本技术直觉并且能提出好问题的人,越来越能构建出过去需要一个小团队、或者根本不值得构建的东西:一个小型电商网站、一个博客、一个本地社交网络、一个公司内部工具、一个小型 CRM、一个工作流应用、研究工具、测试、部署自动化,或者替代某个只有5 个人在用的 SaaS。
不是所有东西。不是 SAP。不是银行。不是安全关键型基础设施。
但“如今便宜到可以直接动手构建的软件”这一空间正在迅速扩大。
算力越来越不是瓶颈
如果是在2 周前,我会写:“算力就是问题。”今天我会换个说法。
对于越来越多的小型应用、研究任务和内部工具来说,算力不再是约束性瓶颈。显然,还有一些大型工作负载并非如此。前沿训练很昂贵。服务庞大的用户群很昂贵。视频、科学工作负载以及运行时间极长的自主系统,都能烧掉海量算力。
但对我在这里谈论的那种工厂车间来说(小团队、个人开发者、编程智能体、研究智能体、测试和部署),曲线移动得非常快。我怀疑,今天一些昂贵的边缘情况,是几个月优化的问题,而不是几年。
DeepSeek 在 KV 缓存上的工作,正是那种让我这样想的改变。
然后还有 Meta Muse
Muse 是另一个有趣的信号。Meta 把它作为个人 AI 智能体推出:它运行在一台专用的安全虚拟机里,有自己的浏览器,可以代表用户执行多步骤任务。Meta 的产品页面目前把 Muse 描述为免费但有使用额度,付费订阅则可获得更多用量。
在发布前后,Mark Zuckerberg 把最初的免费额度描述为每周约 100,000,000 token。产品额度会变化,所以我把这个数字当作发布时经济账的一个快照,而不是一项永久承诺。
但话说回来。
一亿个 token。每周。免费。
这足以容纳大量实验、部署、测试、研究、浏览和智能体工作。一个拥有 Muse、并且基本懂得如何提出好问题的人,已经可以用一个小型电商网站、一个博客、一个本地社区工具,或者一个替代某个小型 SaaS 订阅的内部应用,走得相当远。
这和我们哪怕一年前的可及性曲线也完全不同。
而正是在这里,我最初那个关于剥削智能体的玩笑变得稍微更有意思了。我不知道“智能体剥削”有一天是否会成为一个独立而有意义的伦理范畴。眼下,我认为更实际的伦理问题关乎我们。
如果合成劳动力变得极其便宜,我们会选择把什么委派出去?我们会停止学习什么?我们会在不理解的情况下上线什么?当再生成 50,000 行代码几乎不花什么钱,但评审它们仍然需要判断力时,会发生什么?当智能体蜂群做出蠢事时,谁来负责?
现在,在我的工厂车间里,答案非常简单:我。
我仍然管理这些智能体。我仍然亲自动手。我评审重要的东西。我决定什么会被合并和部署。我就是人在回路中的那个人。
那也能自动化吗?大概能。但还是那句话……为什么?你总得找点事情做。
PS
如果你是公司、个人、智能体、智能体蜂群,或者一组组织得可疑地井井有条的子进程,我愿意合作,也欢迎挑战、机会和研究。
联系方式在我的主页上。
🏭🤖💪🏻